Ayer terminé de probar una configuración de aceleración MiniMax H3. Hoy aterrizó otro.
Por supuesto que sí.
Así es ComfyUI en 2026: su punto de referencia apenas está frío antes de que alguien lance un nuevo nodo y haga que todo parezca obsoleto. La configuración de ayer fue EasyCache más SageAttention. Las incorporaciones de hoy fueron Spectrum y otro complemento de velocidad que circula en la comunidad china ComfyUI. Aproximadamente al mismo tiempo, Wan-Animate-2 finalmente se volvió de código abierto, lo que me dio una excusa más para compararlo con SCAIL-2.
Entonces esto se convirtió en tres pruebas en lugar de una:
- EasyCache + SageAttention versus Spectrum en MiniMax H3;
- la salida regular de H3 versus un ajuste NSFW realizado por la comunidad;
- Wan-Animate-2 versus SCAIL-2 para animación de personajes.
La versión corta: EasyCache ganó la prueba de tiempo por una milla, el clip NSFW publicado demuestra menos de lo que se afirma y las dos muestras de animación de personajes no están lo suficientemente controladas como para coronar a un ganador. La versión más larga es más interesante.
Nota del editor: Esta es una adaptación nativa en inglés de notas prácticas publicadas originalmente por 赵KK搞AI en WeChat, no una traducción línea por línea. Los resultados de las pruebas en primera persona y las opiniones se conservan del autor original; El contexto técnico y las advertencias se compararon con los repositorios oficiales del proyecto.
Primero, la prueba de velocidad:692 segundos frente a 1,590 segundos
Ambas ejecuciones de MiniMax H3 generaron un clip vertical de 15 segundos a 544 × 960. El flujo de trabajo EasyCache + SageAttention finalizó en 692.69 segundos, o sobre 11 minutos 33 segundos.espectro tomó 1,590.15 segundos, o sobre 26 minutos 30 segundos.
Eso hace que EasyCache + SageAttention sea aproximadamente 2.3 veces más rápido en esta carrera. Redujo el tiempo de espera en poco más del 56%.
| Configuración del MiniMax H3 | Producción | tiempo medido | Resultado relativo |
|---|---|---|---|
| EasyCache + SageAtención | 15s, 544 × 960 | 692.69s | 1.0× |
| Espectro | 15s, 544 × 960 | 1,590.15s | 2.3 veces más largo |
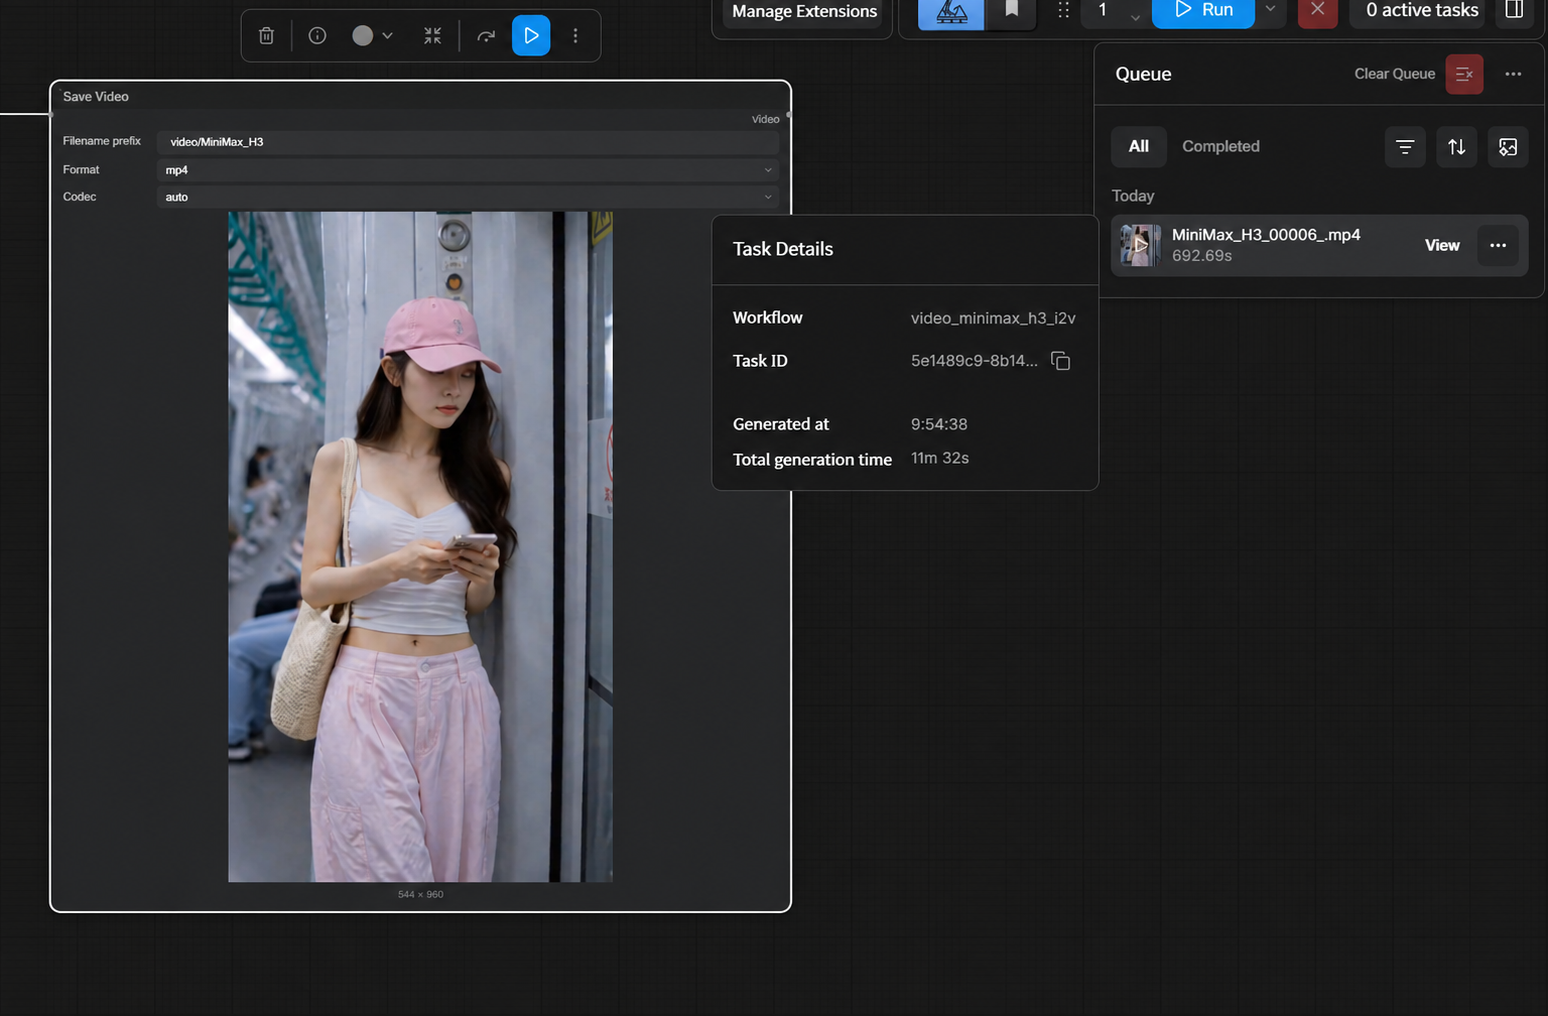
EasyCache + SageAttention se ejecuta según lo registrado en ComfyUI. Imagen fuente:赵KK搞AI.
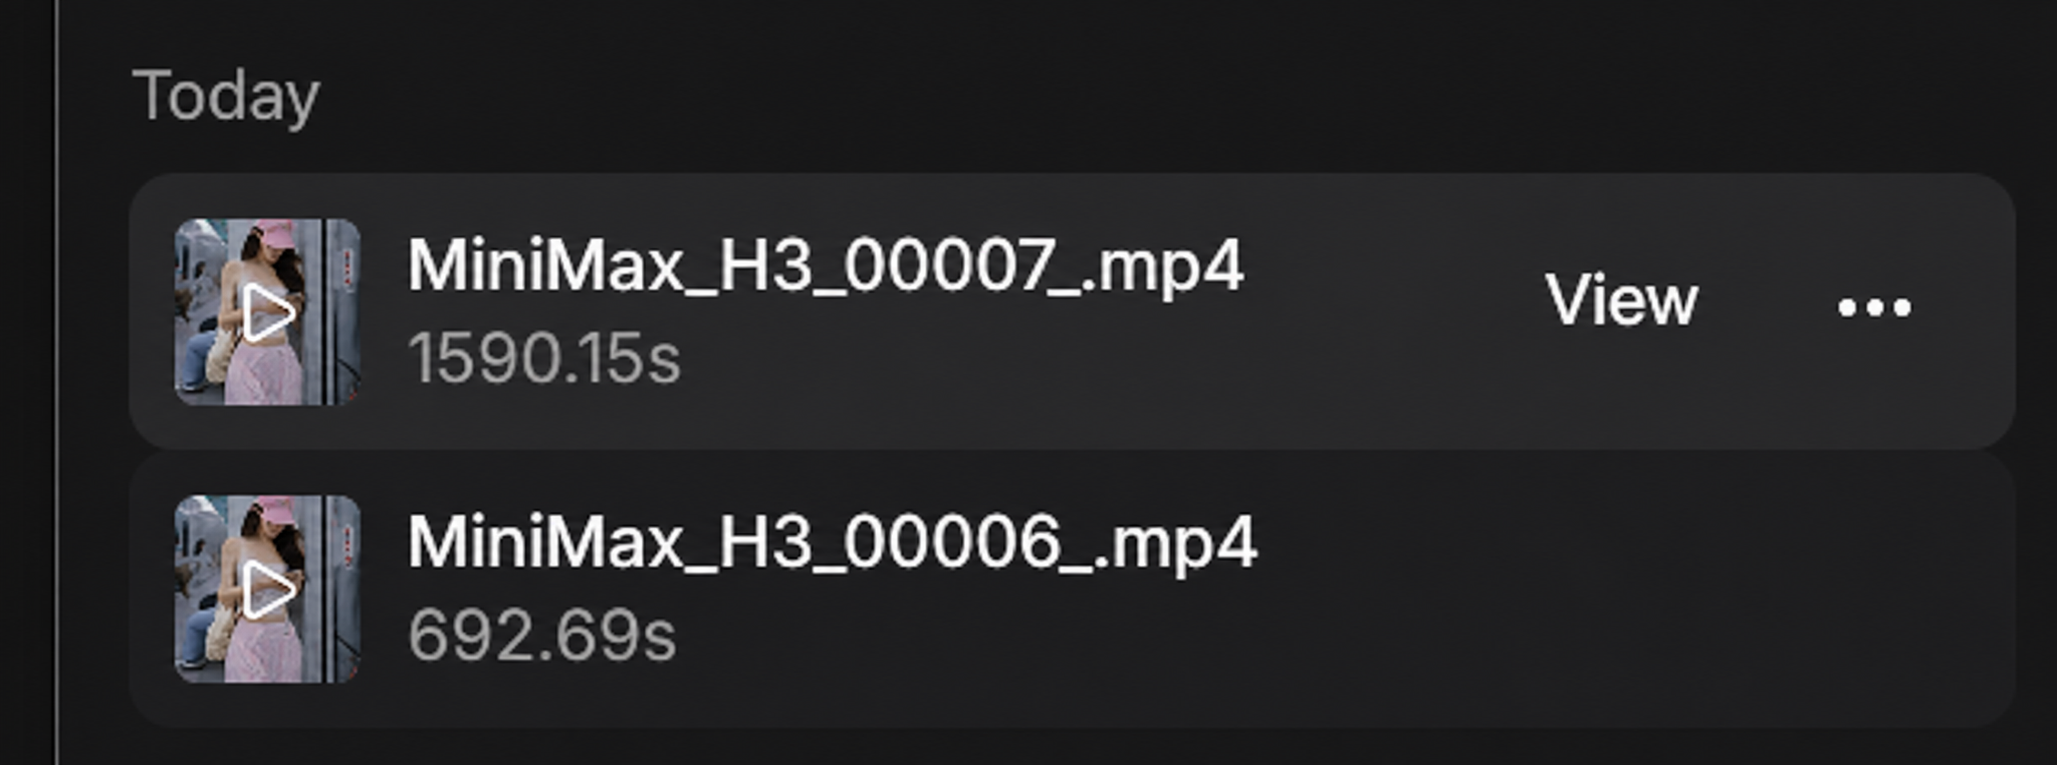
Los dos tiempos de tarea registrados. Esta es la útil captura de pantalla; nos salva de pretender que "me sentí más rápido" es un punto de referencia. Imagen fuente:赵KK搞AI.
La salida MiniMax H3 de 15 segundos adjunta a la prueba de aceleración. Vídeo fuente:赵KK搞AI.
Antes de que alguien convierta esa cifra de 2.3× en una ley universal: no. El artículo no proporciona una hoja de reproducibilidad completa con el modelo de GPU, las versiones de software, las semillas, los parámetros de muestreo y la configuración por nodo. Este es un resultado real del flujo de trabajo, no una tabla de clasificación de velocidad revisada por pares.
Aún así, una diferencia tan grande no es nada. Si mi única pregunta fuera "¿qué configuración me permite obtener otro borrador antes en esta máquina? ", EasyCache + SageAttention sería la primera opción obvia.
Por qué EasyCache fue más rápido aquí
Los dos aceleradores no hacen el mismo truco.
EasyCache es el enfoque más agresivo. En términos sencillos, intenta reutilizar el trabajo de pasos anteriores de eliminación de ruido en lugar de ejecutar el cálculo completo nuevamente cada vez. Cuando la generación permanece estable, se puede ahorrar una gran cantidad de cálculo. El riesgo es igualmente fácil de entender: Si la estimación almacenada en caché comienza a desviarse, el error puede acumularse.
Espectro es más comedido. Su implementación ComfyUI utiliza pronóstico de características (pronóstico de Chebyshev y regresión de crestas) para predecir características intermedias del transformador y luego permite que el modelo continúe refinando el resultado. Es menos como fotocopiar el pase anterior y más como dibujar el siguiente de la trayectoria reciente antes de que el modelo lo limpie.
Eso hace que Spectrum sea técnicamente interesante. No lo hizo rápido en esta prueba en particular.
| que cambia | EasyCache + SageAtención | Espectro |
|---|---|---|
| idea básica | Reutilice el cálculo anterior y reduzca el costo de atención | Pronóstico de características intermedias de la historia reciente. |
| De donde viene la ganancia | Saltarse trabajos más repetidos | Evitar algunos cálculos del transformador |
| Probable compensación | Más oportunidades de deriva acumulada | Aceleración más conservadora |
| Resultado en esta prueba | 692.69s | 1,590.15s |
Lo que falta es un A/B visual adecuado: La misma semilla, la misma fuente, el mismo mensaje, la misma configuración de muestreo, ambas salidas disponibles con máxima calidad. Sin eso, puedo decirte qué carrera terminó primero. Honestamente no puedo decirte qué método conservó más detalles.
Esa distinción importa. También es la forma en que tratamos de separar un reclamo de un proveedor de un resultado observable en el Metodología de revisión de NSFWAITool. Un cronómetro puede comprobar la velocidad. No puede probar la calidad de la imagen por sí solo.
El “modelo NSFW MiniMax H3” necesita un asterisco
La versión NSFW discutida aquí fue no es un lanzamiento oficial de MiniMax. El repositorio oficial MiniMax H3 describe un modelo multimodal de propósito general. La versión orientada a adultos provino de un afinador comunitario independiente que supuestamente probó cinco versiones.
El enlace desapareció rápidamente y ya devolvía un 404 cuando lo comprobé. Esto es molesto, pero también es normal en este rincón de la IA de código abierto: un modelo se puede publicar, duplicar, cambiar de nombre o eliminar antes de que la mayoría de las personas terminen de descargarlo. Si un flujo de trabajo de producción depende de que un repositorio comunitario no verificado permanezca en línea para siempre, el flujo de trabajo realmente no existe todavía.
La prueba original utilizó un mensaje de moda largo y multicámara para la línea de base. Especificaba un carrete vertical de 15 segundos, múltiples lentes y ángulos, estilo, música, iluminación e identidad consistentes en todos los cortes. El resultado normal de H3 se encuentra a continuación.
Producción básica del modelo MiniMax H3. La marca "V" visible es parte del clip de origen y se ha conservado. Vídeo fuente:赵KK搞AI.
Para la prueba de adultos, el mensaje mantuvo la misma estructura multicámara pero cambió la progresión del vestuario a una secuencia explícita de desvestirse. Ésta es una forma sensata de probar un ajuste fino: conserve el diseño de la toma y modifique el comportamiento que realmente desea medir.
Aquí está el resultado público incluido con el artículo original:
Avance publicado para el ajuste fino de NSFW de la comunidad. Los subtítulos originales en chino han sido reemplazados por subtítulos en inglés; la marca "V" sigue siendo parte del video fuente. Vídeo fuente:赵KK搞AI.
Y aquí es donde tengo que estropear un poco el marketing: el clip público no muestra la secuencia completa de desvestirse descrita en el mensaje. Se queda vestido y termina con una línea burlona que equivale a: "Si realmente quieres verlo, pruébalo tú mismo". ¿Divertido? Sí. ¿Evidencia del comportamiento completo sin censura? No.
Así que trataría esto como evidencia de que existió un ajuste fino de NSFW H3 de la comunidad y podría producir un adelanto coherente con temática para adultos. No usaría el clip público como prueba de que completó todas las instrucciones explícitas. Esas son dos afirmaciones diferentes, y al juntarlas es como las demostraciones de IA se convierten en una tontería.
Si compara opciones de videos para adultos locales y alojados, cuanto más amplio Directorio de generador de videos porno AI Es un mejor punto de partida que apostar todo a un repositorio eliminado.
Wan-Animate-2 se volvió de código abierto, así que sí, también lo probé
Wan-Animate-2 publicó su código de inferencia y pesos de modelo en agosto de 2026. El proyecto genera un personaje de referencia directamente desde un video fuente mientras intenta preservar la identidad, el movimiento, la expresión y el comportamiento de la cámara. Es un sistema de extremo a extremo, por lo que no necesita un extractor de pose separado ubicado en el medio de la tubería.
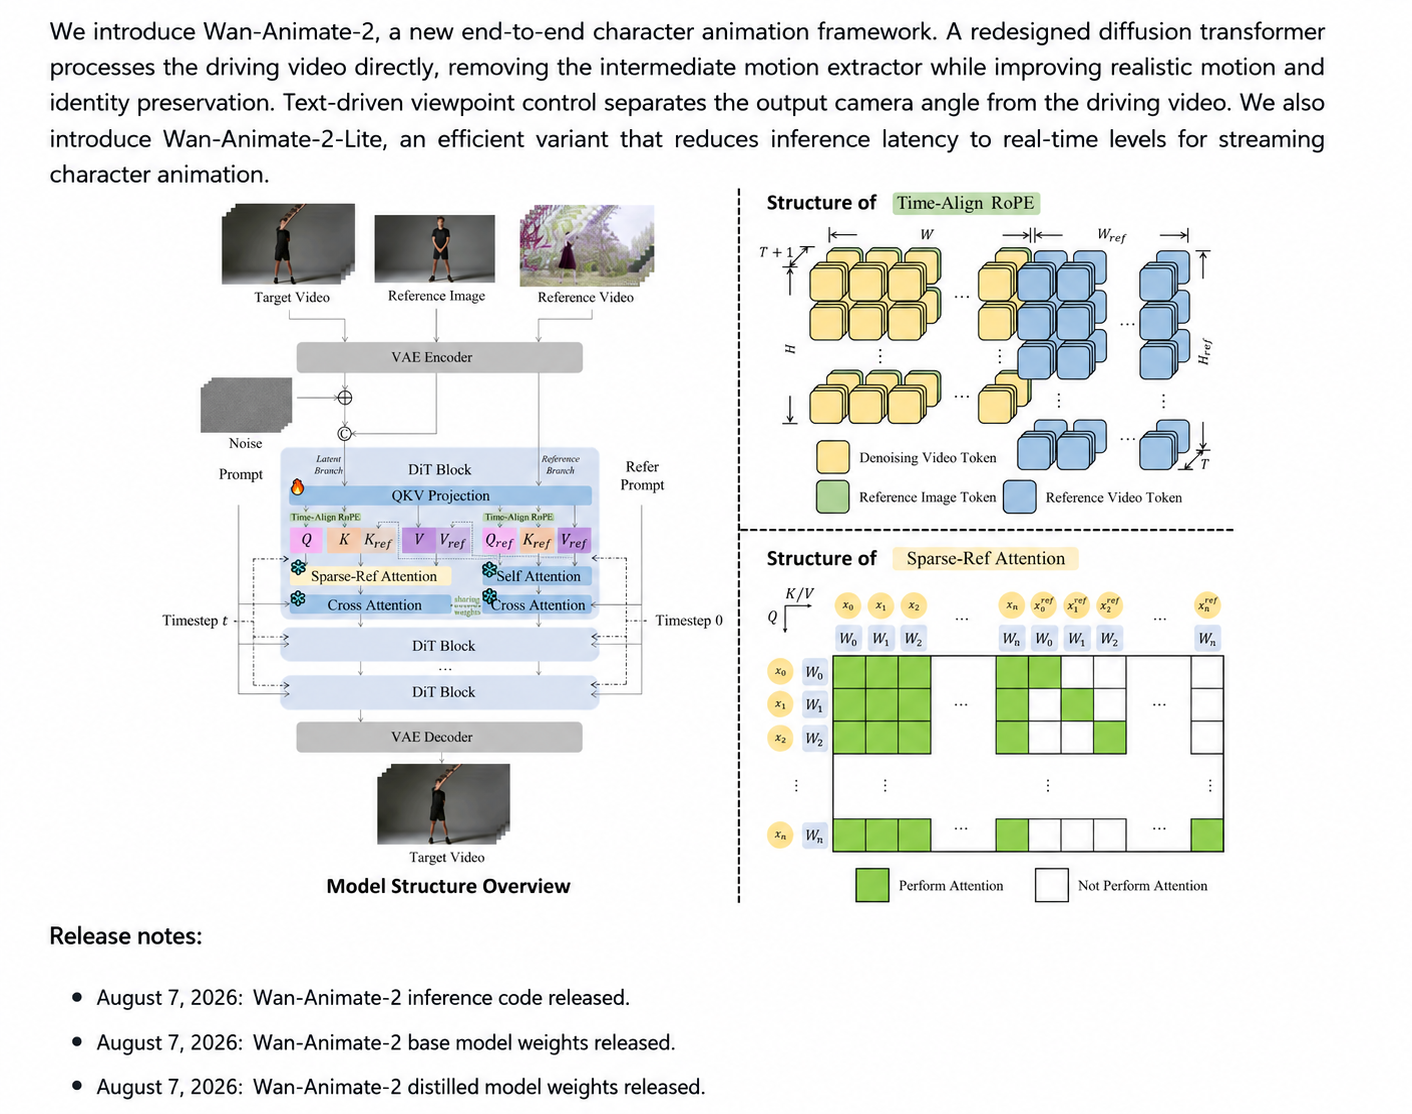
Descripción general del proceso Wan-Animate-2 incluida en el artículo original. Imagen fuente:赵KK搞AI; detalles técnicos: Proyecto Wan-Animate-2.
Desvío rápido, porque aparentemente todavía hay que decir esto: Wan 3.0 no es de código abierto. Eso es decepcionante. No hace que el abuso anónimo dirigido a los desarrolladores sea inteligente o basado en principios. Estás utilizando modelos que otras personas pasaron meses construyendo y luego actúas personalmente traicionado porque no te entregaron el siguiente en tu horario preferido. Si puede construir Wan 4.0 ti mismo, hágalo. Seré el primero en la fila y te pediré que sueltes las pesas.
El hecho de que Wan-Animate-2 sea de código abierto no resuelve mágicamente el argumento de Wan 3.0, pero sigue siendo un lanzamiento significativo. El ecosistema Wan sigue siendo uno de los pocos lugares donde las personas pueden realmente inspeccionar, modificar y conectar el modelo a una canalización privada de ComfyUI. Eso es aún más importante para proyectos para adultos, donde los productos alojados pueden no permitir el material en absoluto. Nuestro más largo Flujo de trabajo de cortometrajes para adultos Wan 2.2 explica por qué el control local se convierte en un requisito de producción una vez que un proyecto crece más allá de unos pocos clips.
La configuración de Wan-Animate-2 tiene un paso que fácilmente se pasa por alto
Antes de ejecutar la animación, la imagen de referencia debe describirse con un LLM. El proyecto oficial recomienda una descripción objetiva de la apariencia y los antecedentes del personaje, excluyendo acciones, juicios subjetivos y especulaciones emocionales.
En inglés natural, la instrucción es básicamente:
Describe sólo lo que está visiblemente presente en la imagen de referencia. Cubre la apariencia, la ropa, el cabello, los accesorios y el fondo del sujeto. No describas acciones. No adivines la personalidad, el estado de ánimo o la intención.
Eso suena complicado hasta que ves por qué ayuda. El video de conducción ya proporciona la acción. Si la descripción del texto inventa otra acción, le has dado al modelo dos directores gritando instrucciones diferentes.
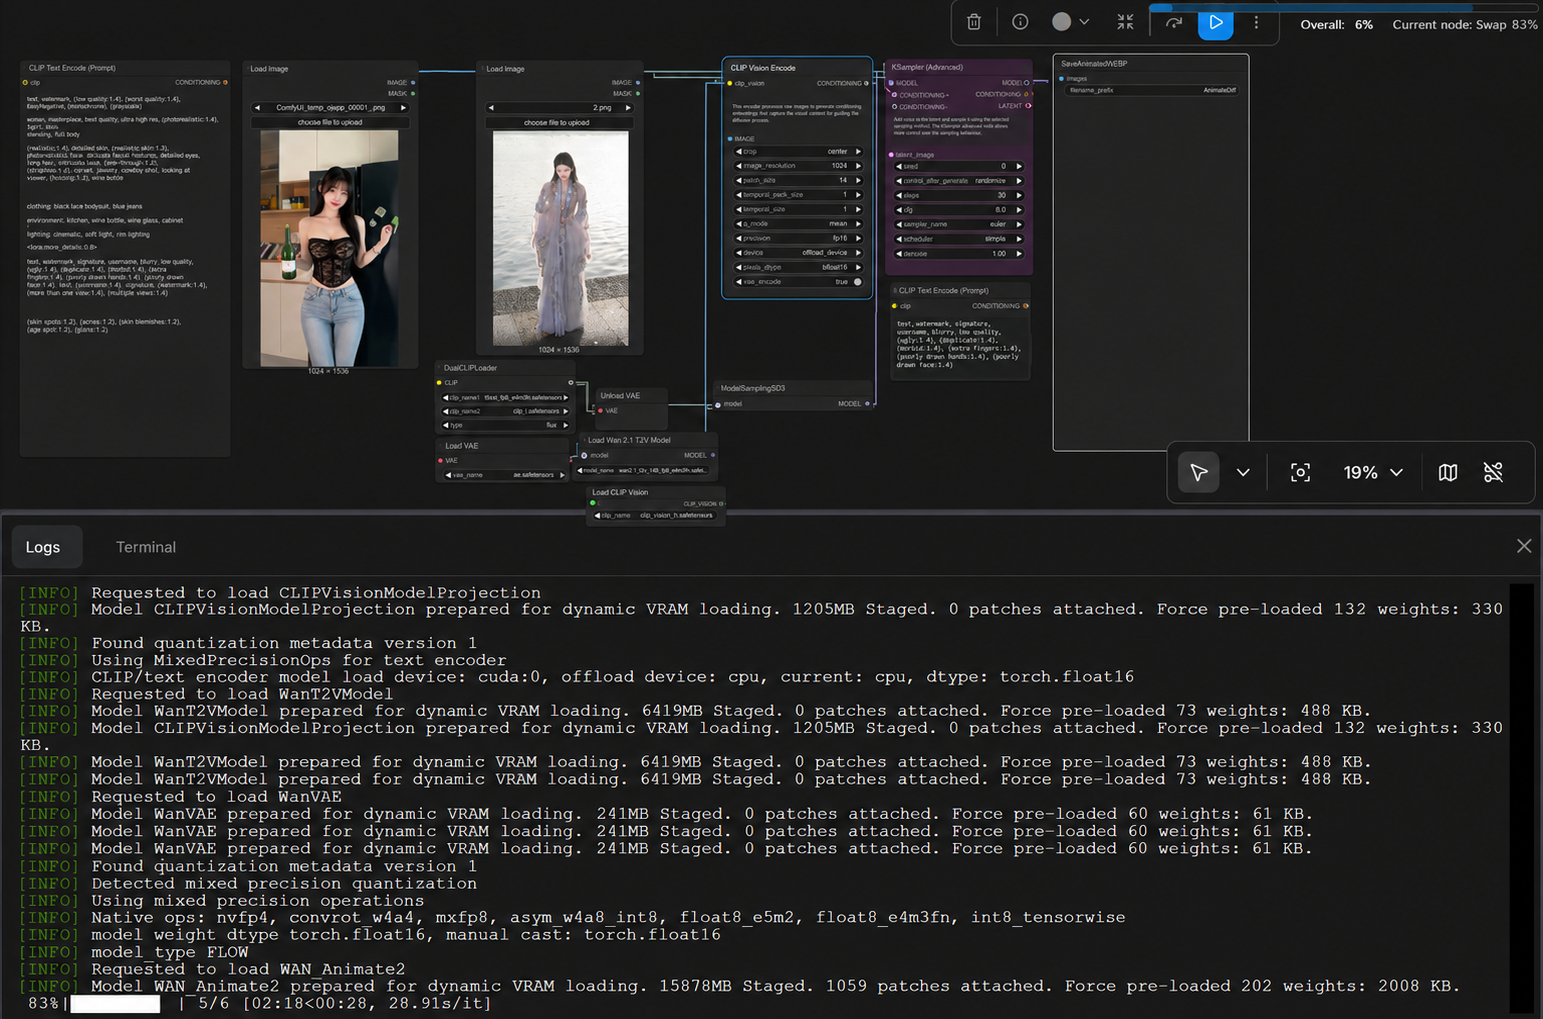
Wan-Animate-2 en ComfyUI. Imagen fuente:赵KK搞AI.
La otra configuración que la gente se equivoca es la longitud del fotograma. A 24 fps, la matemática es simple:
duración en segundos × 24 = recuento de fotogramas objetivo
El flujo de trabajo que se muestra en la fuente utiliza fragmentos de 81 fotogramas, por lo que los clips más largos requieren varias pasadas.
| Duración objetivo | Fotogramas a 24 fps | Se necesitan fragmentos de 81 fotogramas |
|---|---|---|
| 3 segundos | 72 | 1 |
| 5 segundos | 120 | 2 |
| 8 segundos | 192 | 3 |
| 10 segundos | 240 | 3 |
| 15 segundos | 360 | 5 |
| 30 segundos | 720 | 9 |
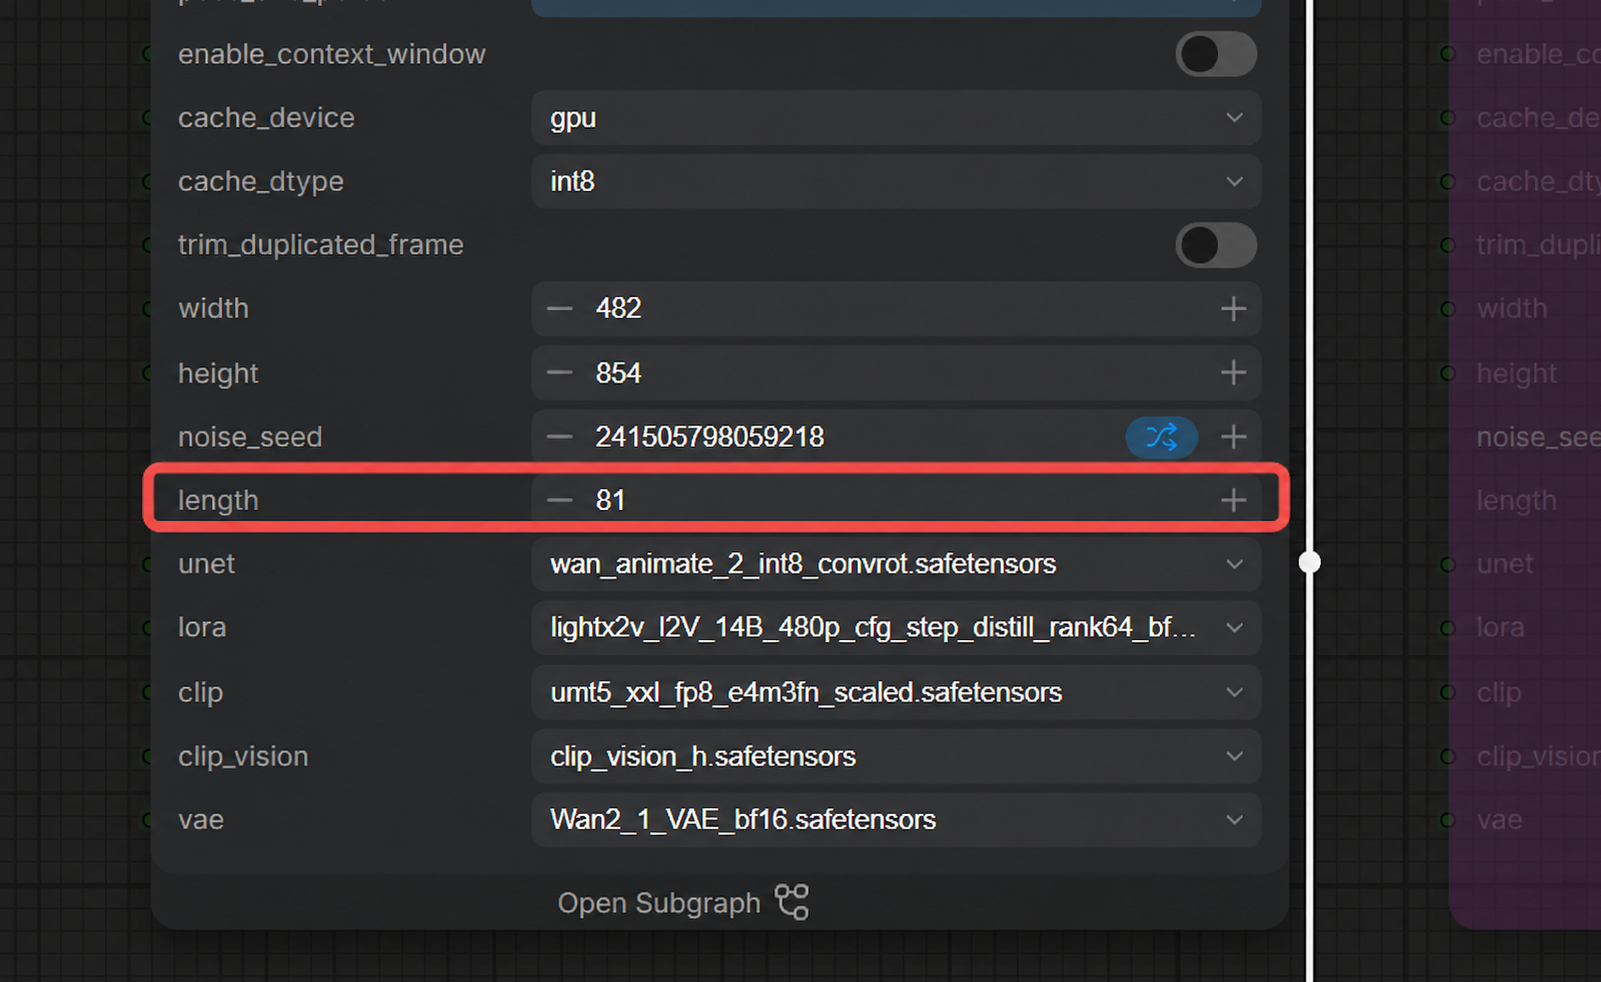
La configuración de longitud de 81 fotogramas utilizada en el flujo de trabajo. Imagen fuente:赵KK搞AI.
La configuración predeterminada de 720p del repositorio oficial está ajustada para ocho GPU A800, con una configuración probada de 480p en dos A800. Ese no es un pequeño requisito amigable de "hacer clic en el mensaje de cola en mi computadora portátil". Las optimizaciones de la comunidad seguirán reduciendo la memoria, pero cualquiera que escribe sobre esto como si la animación de personajes locales fuera gratuita claramente nunca ha visto una barra de progreso arrastrarse a través de un flujo de trabajo real.
Wan-Animate-2 versus SCAIL-2: los clips no resultan ser un ganador
El SCAIL-2 El proyecto toma una ruta similar de principio a fin. Evita una representación de pose intermedia y agrega semántica de máscara más condicionamiento de referencias múltiples. Su lanzamiento oficial admite flujos de trabajo de 512p y 704p, y el proyecto recomienda la variante basada en pose a 704p.
Aquí está la muestra de Wan-Animate-2 conservada del artículo original:
Muestra Wan-Animate-2. El archivo fuente alterna rápidamente la vista de conducción/referencia y el carácter generado; se reproduce aquí sin modificaciones. Vídeo fuente:赵KK搞AI.
Y aquí está la muestra de SCAIL-2:
Muestra de animación de personajes SCAIL-2. Vídeo fuente:赵KK搞AI.
No voy a anunciar un ganador de estos dos clips, porque sería una precisión falsa. Usan diferentes personajes, diferentes fuentes de movimiento, diferentes encuadres y diferentes duraciones. La carga de Wan-Animate-2 dura solo unos 2.7 segundos y alterna vistas tan rápidamente que los defectos temporales son difíciles de juzgar. El clip SCAIL-2 funciona durante casi nueve segundos y es mucho más fácil de inspeccionar, pero “más fácil de inspeccionar” no es lo mismo que “mejor modelo”.
Una comparación real necesita la misma imagen de referencia, video de conducción, resolución, recuento de fotogramas, hardware, política de semillas y posprocesamiento. Luego calificaría la retención de identidad, la estabilidad de la mano, la recuperación de la oclusión, la expresión facial, el movimiento de la tela, la filtración del fondo y el tiempo total de renderizado. Cualquier cosa menos es una comparación de carretes de demostración.
Lo que realmente usaría después de estas pruebas
Para la velocidad de iteración de MiniMax H3, comenzaría con EasyCache + SageAtención. La brecha en esta carrera es demasiado grande para ignorarla. Aún así, renderizaría un puñado de muestras coincidentes antes de aceptar el compromiso de calidad, porque la velocidad que daña silenciosamente las caras o el movimiento no es velocidad; simplemente genera rechazos más rápido.
yo trataría Espectro como la alternativa interesante y más conservadora, no como la ganadora de esta ronda de cronometraje. Merece una prueba de calidad controlada, especialmente si EasyCache comienza a acumular errores visibles en una toma más larga o más difícil.
Para el comunidad NSFW H3 ajuste finoEsperaría por un repositorio estable, una tarjeta de modelo, un historial de versiones y muestras reproducibles. Un enlace desaparecido y un adelanto tímido son suficientes para despertar mi curiosidad. No son suficientes para construir un flujo de trabajo de producción.
Para Wan-Animate-2 versus SCAIL-2, ejecutaría mis propias entradas coincidentes. Ambos proyectos son lo suficientemente abiertos como para merecer pruebas serias. Los ejemplos del artículo original simplemente no responden la pregunta.
Esto puede parecer menos emocionante que “el modelo A destruye al modelo B”, pero es mucho más útil. Ya hay suficientes falsas certezas en la evaluación comparativa de la IA. No necesitamos fabricar otro ganador a partir de dos videos no relacionados.
Preguntas frecuentes
¿MiniMax H3 es oficialmente un modelo NSFW?
No. MiniMax H3 es un modelo multimodal de uso general. La compilación NSFW discutida aquí fue un ajuste fino de la comunidad independiente, no un lanzamiento oficial de MiniMax.
¿EasyCache es siempre más rápido que Spectrum en MiniMax H3?
No probado. EasyCache + SageAttention fue aproximadamente 2.3 veces más rápido en esta prueba específica de 15 segundos y 544 × 960. Diferentes hardware, semillas, versiones de nodos y configuraciones de calidad podrían cambiar el resultado.
¿La demostración pública de NSFW completó el mensaje explícito completo?
El clip publicado no muestra eso. Permanece vestido y termina como un adelanto, por lo que no puede verificar la secuencia completa de desvestirse descrita en el mensaje.
¿Es Wan-Animate-2 mejor que SCAIL-2?
Los dos clips originales no son una comparación controlada. Utilizan diferentes entradas y longitudes, por lo que muestran que ambos flujos de trabajo se ejecutan, no cuál es mejor.
¿Por qué el flujo de trabajo Wan-Animate-2 utiliza 81 fotogramas?
Esa es la longitud del fragmento utilizada en el flujo de trabajo de ComfyUI demostrado. A 24 fps, los objetivos más largos se dividen en múltiples fragmentos de 81 fotogramas y luego se ensamblan.
¿Cuánto hardware GPU necesita Wan-Animate-2?
El proyecto oficial documenta una configuración predeterminada de 720p en ocho GPU A800 y una configuración probada de 480p en dos A800. Los nodos comunitarios y la descarga pueden reducir el requisito, generalmente a costa de la velocidad.
¿Se pueden utilizar estos modelos para contenido para adultos?
La disponibilidad local no elimina los requisitos legales o de consentimiento. Usa únicamente personajes claramente adultos e imágenes de referencia, voces y secuencias de conducción con licencia adecuada. No crees deepfakes íntimos de personas reales sin consentimiento.