La respuesta corta: la parte interesante de Huang Guo No es que la IA estuviera involucrada. La cuestión es que los realizadores no le pidieron a un modelo que creara una película de ocho minutos a partir de una sola indicación. Según las notas de producción proporcionadas para este estudio de caso, dividieron la película en 117 tomas cortas y controlaron la identidad, los fotogramas clave, el movimiento, el diálogo y el acabado como problemas separados. Wan 2.2 fue la base porque el proyecto necesitaba pesos locales, una tubería modificable y una producción por lotes sostenida, no porque a Seedance le faltara calidad visual.
Sobre la evidencia: El tiempo de ejecución de ocho minutos, el recuento de 117 tomas, la duración media de las tomas de 3.2 segundos y el proceso específico del proyecto provienen del material de producción de Huangguo proporcionado para este artículo. Los enlaces externos verifican las capacidades públicas de Wan, Seedance, Wan-S2V y NVIDIA; esas empresas no han verificado el registro de producción privada de la película.
Este artículo cubre la producción legal basada en el consentimiento que involucra únicamente a personajes claramente adultos. No respalda contenido con edades ambiguas, menores o deepfakes íntimos no consensuados.
- ¿Por qué Wan 2.2?
- ¿Por qué 117 disparos?
- el oleoducto
- Diálogo y publicación
- Hardware
- Preguntas frecuentes
¿Por qué Wan 2.2 en lugar de Seedance?
Seedance no es el modelo débil en esta comparación. La página oficial de ByteDance destaca referencias de imágenes, audio y video, además de control sobre el rendimiento, la iluminación y el movimiento de la cámara. Para un proyecto convencional que desea una capacidad alojada pulida sin mantener la infraestructura local, eso puede ser una gran ventaja.
Huangguo tenía un conjunto de restricciones diferente. Más de cien disparos necesitaron muestreos repetidos. La identidad, el movimiento y el diálogo de los personajes tuvieron que ajustarse de forma independiente. Un disparo fallido tenía que ser recuperable en cualquier etapa. El estudio también necesitaba ser propietario de sus activos de formación y de su cola de generación. Wan 2.2 publica pesos de modelo y código de inferencia, con rutas T2V, I2V, TI2V y S2V que se pueden integrar en un sistema de renderizado privado.
| Requisito de producción | Flujo de trabajo local Wan 2.2 | Servicio público de semillas |
|---|---|---|
| Acceso al modelo | Pesos descargables y código de inferencia. | Capacidad finalizada a través de productos alojados o API |
| inferencia local | Instrucciones oficiales de ejecución local. | La página de modelo pública no ofrece pesos base descargables |
| LoRA y entrenamiento dirigido | Puede conectarse a LoRA comunitario/herramientas de capacitación completa | La pila de capacitación del modelo base no se expone a través de la interfaz pública |
| producción por lotes | Colas, cachés y programación de múltiples nodos autoadministrados | Sujeto a cuotas de API, precios y reglas de servicio |
| Contenido para adultos | Ejecución local; el productor sigue siendo responsable de la ley, el consentimiento y la seguridad | Volcano Engine afirma que su sistema de seguridad detecta y bloquea el riesgo pornográfico |
| Mejor ajuste | Línea de producción privada reversible y entrenable | Cómoda generación multimodal para un trabajo que cumple con las políticas |
Esta es una decisión del flujo de trabajo, no una clasificación universal de calidad de imagen. Seedance ofrece un sólido servicio gestionado. Huangguo necesitaba ser dueño de los pesos, los datos y la lógica de programación. La propia página de creación de seguridad de Volcano Engine también dice que su plataforma controla entradas y salidas claramente no conformes, con especial atención al riesgo pornográfico, lo que lo descarta como el generador central de este caso.
¿Por qué dividir ocho minutos en 117 tomas?
Las generaciones más largas multiplican el número de cosas que pueden derivar: rostros, manos, ropa, geometría de fondo, contacto entre personajes, iluminación y movimiento de cámara. Un pequeño error en una interacción compleja puede agravarse en cuestión de segundos. Los planos cortos no tienen automáticamente un ritmo más rápido; hacen que cada renderizado sea comprobable.
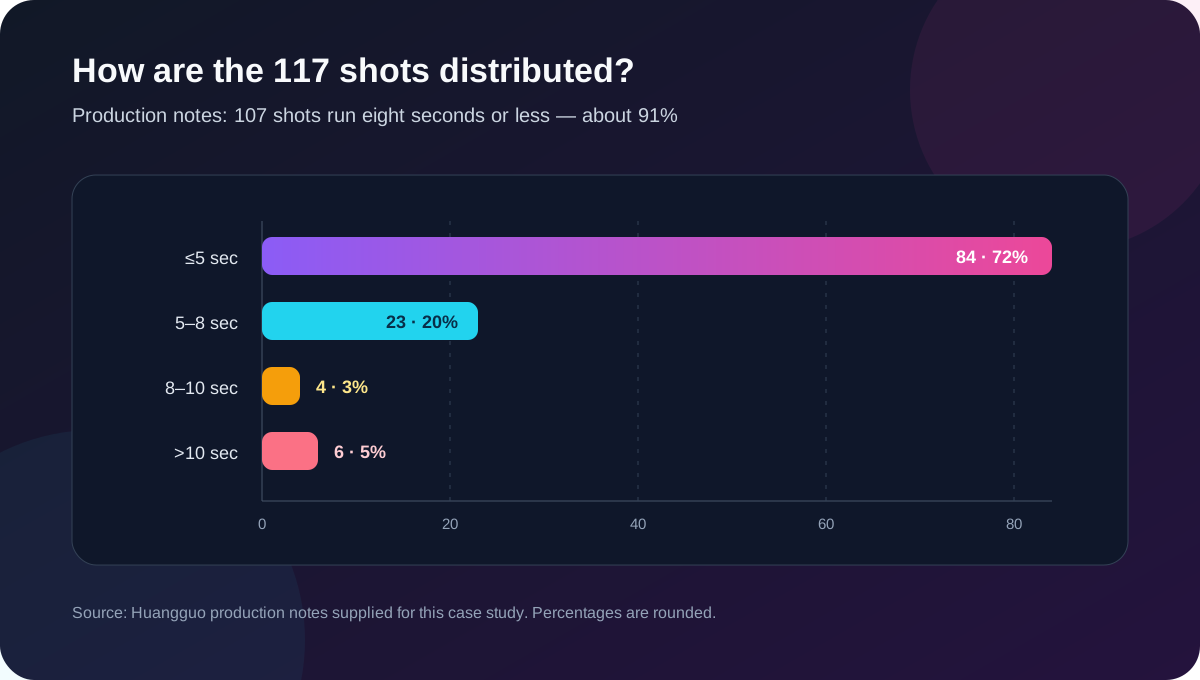
A una toma de tres a ocho segundos se le puede asignar un trabajo: una línea de mirada, un giro, una frase, una fase de movimiento, un cambio de ángulo o un detalle insertado. Se pueden reconstruir escenas complejas a partir de planos generales, primeros planos, inserciones y reacciones. La sensación de actuación continua se crea en la edición en lugar de ser exigida por una generación.
La línea de producción comienza con tomas ejecutables.
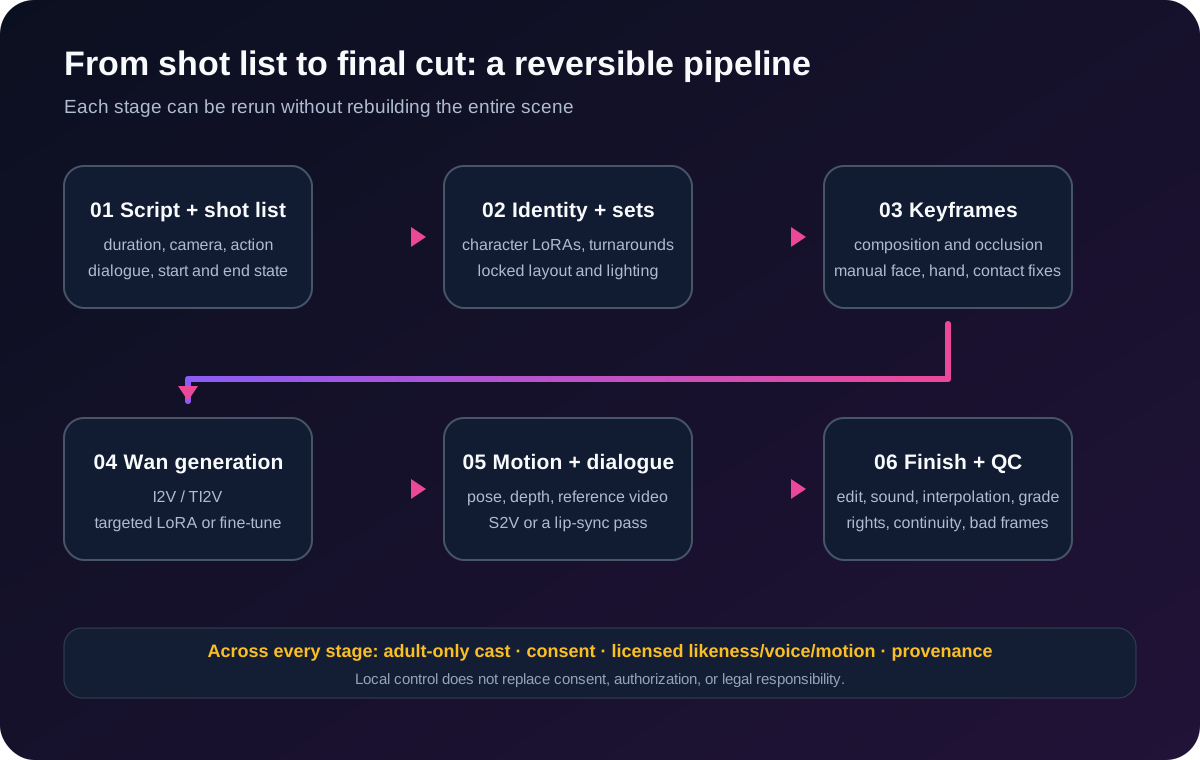
1. Convierta el guión en una base de datos de producción
Un LLM puede ayudar a organizar la trama, las relaciones, el diálogo y el orden de las escenas. Su borrador en prosa no es una tarea de renderizado utilizable. Cada toma necesita una identificación, escenario, reparto, encuadre, posición de la cámara, acción, emoción, diálogo, duración, estado de apertura, estado final, ruta del modelo y cualquier referencia de movimiento o audio requerida.
“Dos personajes completan una interacción compleja en una habitación” es demasiado vago. La escena debe dividirse en entrada, aproximación, reacción, cambio de posición, detalle y estado final. Eso hace que las fallas sean diagnosticables: La composición, la identidad y el movimiento ya no colapsan en el mismo problema.
2. Enrute el drama, el diálogo y la acción complicada por separado.
Las notas de producción clasifican las tomas como narrativa regular, diálogo, contenido para adultos, movimiento complejo, entorno/transición o acabado/VFX. Cada categoría tiene sus propios modelos, adaptadores, parámetros de muestreo, referencias y pruebas de aceptación. Un ajuste preestablecido universal parece eficiente hasta que los reintentos y las reparaciones borran el ahorro.
3. Haz que el personaje LoRA responda solo "¿quién es? "
Los personajes principales necesitan un paquete de identidad limpio: Vistas de frente, de perfil, de tres cuartos, expresiones, cambios de iluminación, vistas de medio cuerpo y de cuerpo completo, y estados de vestuario recurrentes. La edad, la forma del rostro, el maquillaje y las proporciones deben permanecer consistentes en todos los datos; de lo contrario, el adaptador aprende un promedio vago.
La identidad y el movimiento especializado se entrenan por separado. El adaptador de personajes establece quién está en el marco. Un adaptador de contenido o movimiento describe el rendimiento requerido. Esa modularidad permite al estudio reemplazar un personaje sin volver a entrenar todo el conjunto de movimientos, o mejorar el movimiento sin cambiar la cara del intérprete.
Una distinción técnica importa: El comunicado oficial de Wan proporciona pesos y código de inferencia. La capacitación de LoRA generalmente se realiza a través de herramientas como DiffSynth-Studio, que el repositorio oficial enumera como una integración comunitaria que respalda LoRA y la capacitación completa. No es un botón integrado en un producto Wan alojado.
4. Bloquear conjuntos recurrentes antes de renderizar
Los dormitorios, salones, hoteles y pasillos necesitan sus propios paquetes de referencia. Se deben fijar las posiciones de puertas y ventanas, la orientación de los muebles, la luz principal, la temperatura del color, el material de las paredes y las posiciones utilizables de las cámaras. Cuanto más interactúa una actuación con camas, sofás o paredes, más obvia se vuelve la deriva espacial. Una plantilla establecida es a la vez una referencia de dirección de arte y un sistema de coordenadas para el control posterior de la pose y la profundidad.
Cree la imagen fija correcta antes de pedirle que se mueva
Las tomas narrativas habituales comienzan como fotogramas clave aprobados. El fotograma establece identidad, expresión, vestuario, composición, luz, escenografía y pose inicial. Las tomas más complicadas también resuelven la cantidad de personajes, la posición relativa, la orientación del cuerpo, la oclusión, el contacto ambiental, el ángulo de la cámara y los límites del cuadro antes de que comience la generación del video.
Cada fotograma clave debe revisarse manualmente. Los rostros, los ojos, las manos, las conexiones de las extremidades, las proporciones, los bordes de la ropa, el contacto con los muebles, los reflejos, el texto de fondo y los objetos adicionales son más baratos de arreglar una vez en la imagen original que en docenas de fotogramas de video.
Las tres capas de control para disparos especializados
Capa 1: El fotograma clave bloquea la identidad, la pose y la cámara.
Un modelo de imagen especialmente diseñado y adaptadores crean el marco de apertura aprobado. Esta capa responde quién está presente, dónde está y cómo está enmarcada la escena. Deja menos espacio para que el modelo de video rediseñe la relación entre los sujetos.
Capa 2: Wan 2.2 I2V/TI2V maneja el tiempo
El marco aprobado ingresa a una ruta Wan 2.2 I2V o TI2V con los adaptadores específicos o el ajuste requerido por esa toma. Esta capa maneja la continuidad del movimiento, la retención de identidad, la persistencia de la textura, el movimiento de la cámara y la sincronización. La documentación oficial de Wan dice que TI2V-5B admite tanto texto a video como imagen a video a 720p y 24 fps, y puede ejecutarse en una GPU de consumo como una RTX 4090.
Capa 3: Las referencias autorizadas describen cómo se mueve la acción.
El movimiento difícil puede agregar videos de referencia autorizados, secuencias de posturas esqueléticas o información de profundidad. Esas entradas limitan la trayectoria, la velocidad, el cambio de peso, la orientación, la distancia y el estado inicial/final. Los adaptadores de identidad controlan al intérprete; las referencias controlan el movimiento; la plantilla establecida restringe el espacio. Separar esas responsabilidades reduce el cambio de personajes, las intersecciones corporales y el contacto inestable.
Tomas regulares, diálogos y acabado de 24 a 30 fps.
En tomas normales, la editabilidad supera al espectáculo
Genere varios candidatos, luego verifica la identidad, el cumplimiento del guión gráfico, la línea de visión, la continuidad del vestuario, la continuidad del escenario y si los marcos defectuosos se pueden eliminar limpiamente. Un plano comedido que sobrevive desde el primer fotograma hasta el último tiene más valor que un movimiento de cámara ambicioso que muta a mitad del mismo.
Diálogo: Wan-S2V o un pase de sincronización de labios por separado
El proyecto oficial Wan-S2V describe un modelo que convierte una imagen más audio en video sincronizado con expresiones naturales, movimientos corporales y comportamiento cinematográfico de la cámara. Una toma de diálogo útil todavía implica más que las formas de la boca. La respiración antes del discurso, las pausas, los movimientos oculares, la postura y la reacción después de la línea hacen que la actuación sea creíble. Cuando S2V no es la ruta correcta, el equipo puede generar la toma visual primero y aplicar sincronización de labios en la publicación.
24 fps a 30 fps: los fotogramas duplicados no son interpolación
Las notas de producción dicen que los clips fuente de Wan se generaron a 24 fps y se ajustaron a un maestro de 30 fps. Una conversión de duplicación básica agrega seis fotogramas de salida por segundo, o un fotograma repetido cada cinco fotogramas de salida. En cambio, la interpolación de flujo óptico o IA crea fotogramas intermedios sintéticos y tiene un patrón de artefactos diferente.
Cualquiera de los métodos necesita una revisión a nivel de disparo. Las manos, el cabello, las figuras superpuestas y los movimientos rápidos pueden producir nuevos errores estructurales entre fotogramas de origen que de otro modo serían utilizables. El acabado también incluyó ampliación, eliminación de parpadeo, eliminación de ruido, combinación de colores, corrección de exposición, repintado local, eliminación de marcos defectuosos y estabilización de luz.
El sonido y la edición convierten 117 clips en una sola película
Completar la generación del video sólo significa que existe la materia prima. El diálogo TTS, el ambiente, el sonido de acción, la música, las transiciones, la mezcla, la reducción de ruido y la normalización del volumen crean continuidad auditiva. Los subtítulos, los gráficos de mensajes, las interfaces del sistema, los títulos y los efectos visuales restringidos llevan el paquete narrativo.
La edición final debe preservar la dirección de la pantalla, las líneas de los ojos, el vestuario, la iluminación, la acción en el corte, la sincronización de labios y la sincronización del sonido, al mismo tiempo que se eliminan todos los fotogramas fallidos. AI produjo 117 piezas separadas. La edición los hizo sentir como un corto de ocho minutos.
¿Qué hardware requiere este flujo de trabajo?
VRAM de 24 GB: suficiente para validar, no necesariamente para entregar a escala
El comando TI2V-5B oficial de Wan se puede ejecutar con al menos 24 GB de VRAM mediante la descarga de modelos, la conversión de tipo d y la ubicación de la CPU para T5. Esto es útil para pruebas de personajes, desarrollo rápido, fotogramas clave y clips limitados. Una entrega de 117 disparos es un problema de rendimiento: cada disparo aprobado puede estar detrás de varios intentos rechazados.
GPU dual o múltiples nodos: las colas paralelas son lo más importante
NVIDIA enumera 96 GB de memoria GDDR7 ECC y una potencia máxima de placa de 600 W para la RTX PRO 6000 Blackwell Workstation Edition. Por lo tanto, dos tarjetas representan 192 GB de VRAM agregada y 1,200 W de potencia máxima de la placa; cuatro representan 384 GB y 2,400 W antes de CPU, almacenamiento, memoria y refrigeración.
La VRAM agregada no es automáticamente un grupo de memoria compartida. Dos tarjetas de 96 GB no se comportan inherentemente como una sola tarjeta de 192 GB. El software debe utilizar paralelismo de datos, paralelismo de modelos o trabajos de renderizado separados para beneficiarse. Para 117 tomas, distribuir trabajos independientes entre varios nodos suele ser más flexible que construir una estación de trabajo extrema.
Lista de verificación de derechos y calidad a nivel de disparo
- Cada personaje representado está explícitamente definido y presentado como un adulto.
- Los rostros, las voces, las referencias de movimiento y los datos de entrenamiento tienen autorización y procedencia documentadas.
- Ninguna persona real aparece en contenido deepfake íntimo no consensuado.
- La identidad, el rostro y la estructura corporal coinciden con el diseño de personaje aprobado.
- No hay extremidades fusionadas, intersecciones, anatomía inexplicable ni movimientos físicamente incoherentes.
- El vestuario, la geometría del escenario, la iluminación y la dirección de la pantalla continúan en planos adyacentes.
- Se eliminan el parpadeo, las fallas de textura, el texto falso y los fotogramas interpolados destructivos.
- El diálogo, la expresión facial y el sonido de la acción están sincronizados.
- La velocidad de cuadros, la resolución, el color y el volumen cumplen con la especificación maestra.
- La producción sigue la ley y las reglas de la plataforma tanto en los lugares de producción como de distribución.
Preguntas frecuentes
¿Por qué Wan 2.2 se adapta mejor a este cortometraje de IA para adultos?
No es automáticamente mejor para cada película. Huangguo necesitaba pesas descargables, inferencia local, herramientas de capacitación externas y colas autogestionadas. Para contenido convencional que cumple con las políticas, el flujo de trabajo multimodal alojado de Seedance puede ser más simple.
¿Por qué no utilizar Seedance?
Seedance se ofrece públicamente como un servicio de generación alojado y Volcano Engine documenta controles de seguridad que incluyen riesgo pornográfico. Su interfaz pública tampoco expone la pila de capacitación del modelo base a los usuarios finales. Eso lo hace incompatible con este canal particular de contenido para adultos, sin disminuir sus puntos fuertes para el cine común.
¿Se puede generar una película de IA de ocho minutos de una sola vez?
Actualmente, un flujo de trabajo basado en tomas es más fácil de controlar y reparar. Huangguo utilizó 117 tomas revisadas de forma independiente y luego se basó en la edición y el sonido para generar continuidad.
¿Siguen siendo importantes la difusión estable o el flujo?
Sí. Los modelos de imagen siguen siendo útiles para cambios de personajes, referencias de conjuntos y fotogramas clave. Los modelos de video y la postproducción manejan el movimiento, el diálogo y la continuidad temporal.
¿Deberían fusionarse los LoRA de carácter y contenido?
Generalmente no. Separar la identidad de la capacidad de movimiento o contenido facilita el reemplazo, el reentrenamiento y la depuración. El diseño final aún depende del tamaño del conjunto de datos y del método de entrenamiento.
¿Puede una computadora personal hacer esto?
Puede comenzar con TI2V-5B en una GPU de 24 GB. Sin embargo, “puede renderizar un clip” y “puede entregar 117 tomas aprobadas a tiempo” son umbrales diferentes. El almacenamiento, los reintentos, la gestión de colas y la revisión humana se vuelven igualmente importantes.
La verdadera barrera es una línea de producción privada.
El método Huangguo se puede resumir de la siguiente manera: estructurar la historia como planos ejecutables; bloquear identidad con adaptadores de caracteres; mantener el espacio con plantillas establecidas; aprobar fotogramas clave; animar clips cortos con Wan 2.2 y variantes específicas; guiar movimientos difíciles con referencias autorizadas; enrutar el diálogo a través de S2V o sincronización de labios; luego terminar el sonido, cColor, interpolación y edición en una línea de tiempo de 30 fps.
Seedance representa una poderosa generación de videos alojados. Wan 2.2 proporciona pesos, código de inferencia y más espacio para modificar el sistema. Para este proyecto legal y autorizado, con su énfasis en la privacidad y la producción por lotes repetidos, esa diferencia fue decisiva. La comparación tiene como objetivo ayudar a los lectores a juzgar qué ruta coincide con su propio contenido, presupuesto, habilidad técnica y obligaciones de cumplimiento, no para transmitir un "mejor modelo" universal.
Fuentes oficiales
- Repositorio oficial de Wan 2.2: pesos, inferencias, ejemplos de hardware e integraciones de capacitación comunitaria
- Tarjeta modelo oficial Wan 2.2 TI2V-5B
- Página oficial del proyecto Wan-S2V
- Descripción general oficial de ByteDance Seedance 2.0
- Marco de creación de seguridad Seedance 2.0 de Volcano Engine
- Especificaciones oficiales de NVIDIA RTX PRO 6000 Blackwell