A resposta curta: a parte interessante da Huangguo não é que a IA estivesse envolvida. É que os realizadores não pediram a uma modelo para criar um filme de oito minutos a partir de uma única sugestão. De acordo com as notas de produção fornecidas para este estudo de caso, dividiram o filme em curtas-metragens 117 e identidade controlada, fotogramas-chave, movimento, diálogo e finalização como problemas separados. O Wan 2.2 foi a base porque o projeto precisava de pesos locais, um pipeline modificável e produção em batch sustentada – não porque o Seedance não tenha qualidade visual.
Sobre as evidências: o tempo de execução de oito minutos, a contagem de disparos 117, a duração média do disparo de 3.2 de segundos e o processo específico do projeto provêm do material de produção de Huangguo fornecido para este artigo. Os links externos verificam os recursos públicos de Wan, Seedance, Wan-S2V e NVIDIA; estas empresas não verificaram o registo de produção privada do filme.
Este artigo cobre a produção legal e baseada no consentimento envolvendo apenas personagens claramente adultas. Não endossa conteúdo com idade ambígua, menores ou deepfakes íntimos não consensuais.
Porquê Wan 2.2 em vez de Seedance?
O seedance não é o modelo fraco nesta comparação. A página oficial da ByteDance destaca as referências de imagem, áudio e vídeo, bem como o controlo sobre o desempenho, a iluminação e o movimento da câmara. Para um projeto convencional que pretende uma capacidade alojada melhorada sem manter a infraestrutura local, esta pode ser uma grande vantagem.
Huangguo tinha um conjunto de restrições diferente. Mais de cem fotos necessitaram de amostragem repetida. A identidade, o movimento e o diálogo da personagem tiveram de ser ajustados de forma independente. Um tiro falhado tinha de ser recuperável em qualquer fase. O estúdio também precisava de possuir os seus ativos de treino e fila de geração. Wan 2.2 publica pesos de modelo e código de inferência, com caminhos T2V, I2V, TI2V e S2V que podem ser integrados num sistema de renderização privado.
| Requisito de produção | Fluxo de trabalho Wan 2.2 local | Serviço de sementeira pública |
|---|---|---|
| Acesso ao modelo | Pesos para download e código de inferência | Capacidade finalizada através de produtos alojados ou APIs |
| Inferência local | Instruções oficiais de execução local | A página do modelo público não oferece pesos base para o download |
| LoRA e treino direcionado | Pode ligar-se a ferramentas comunitárias LoRA/formação completa | A pilha de treino do modelo base não é exposta através da interface pública |
| Produção em lote | Filas auto-geridas, caches e agendamento de vários nós | Sujeito a quotas de API, preços e regras de serviço |
| Conteúdo adulto | Execução local; o produtor continua responsável pela lei, consentimento e segurança | Volcano Engine afirma que o seu sistema de segurança deteta e bloqueia riscos pornográficos |
| Melhor ajuste | Linha de produção privada treinável e reversível | Geração multimodal conveniente para o trabalho em conformidade com as políticas |
Esta é uma decisão de fluxo de trabalho, não uma classificação universal de qualidade de imagem. A Seedance oferece um serviço gerido forte. Huangguo precisava de propriedade de pesos, dados e lógica de agendamento. A própria página de criação de segurança do Volcano Engine afirma ainda que a sua plataforma controla entradas e saídas claramente não conformes, com atenção específica ao risco pornográfico, o que o exclui como gerador central neste caso.
Porquê dividir oito minutos em tomadas 117?
Gerações mais longas multiplicam o número de coisas que podem flutuar: rostos, mãos, roupas, geometria de fundo, contacto entre personagens, iluminação e movimento de câmara. Um pequeno erro numa interação complexa pode aumentar em segundos. As tomadas curtas não são automaticamente mais rápidas; tornam cada renderização testável.
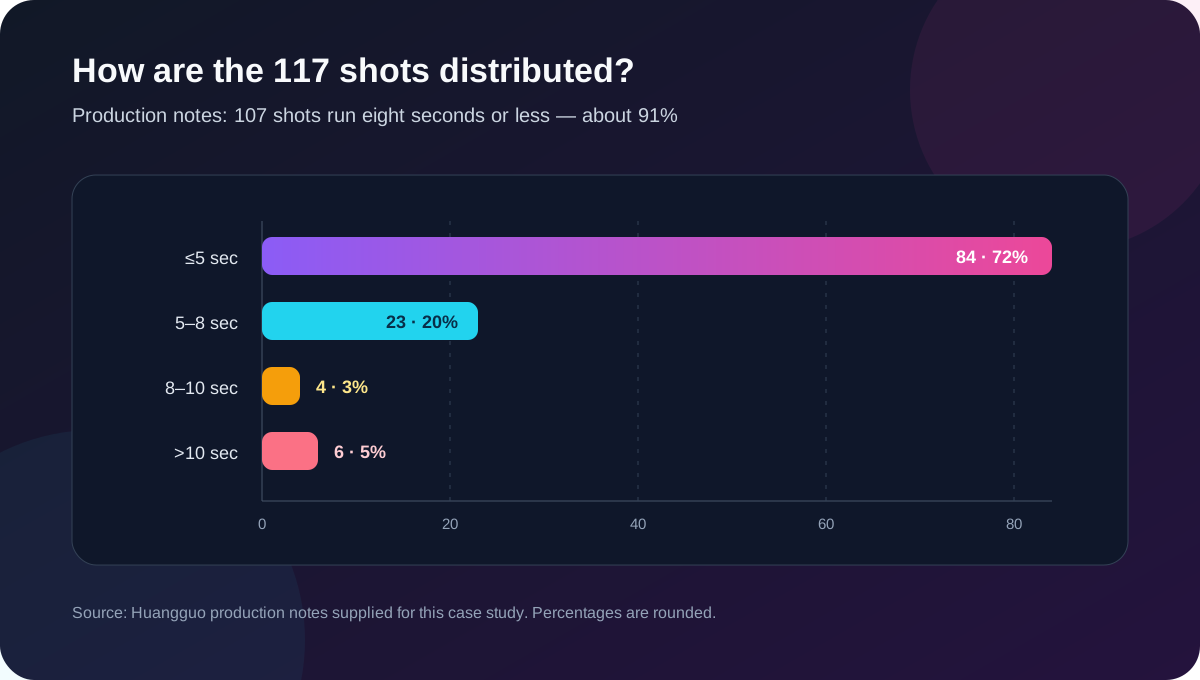
Uma cena de três a oito segundos pode receber uma tarefa: uma linha de olho, um ponto de viragem, uma frase, uma fase de movimento, uma mudança de ângulo ou uma inserção de pormenor. Cenas complexas podem ser reconstruídas a partir de planos gerais, grandes planos, inserções e reações. A sensação de performance contínua é criada na edição em vez de ser exigida a uma geração.
A linha de produção começa com tomadas executáveis
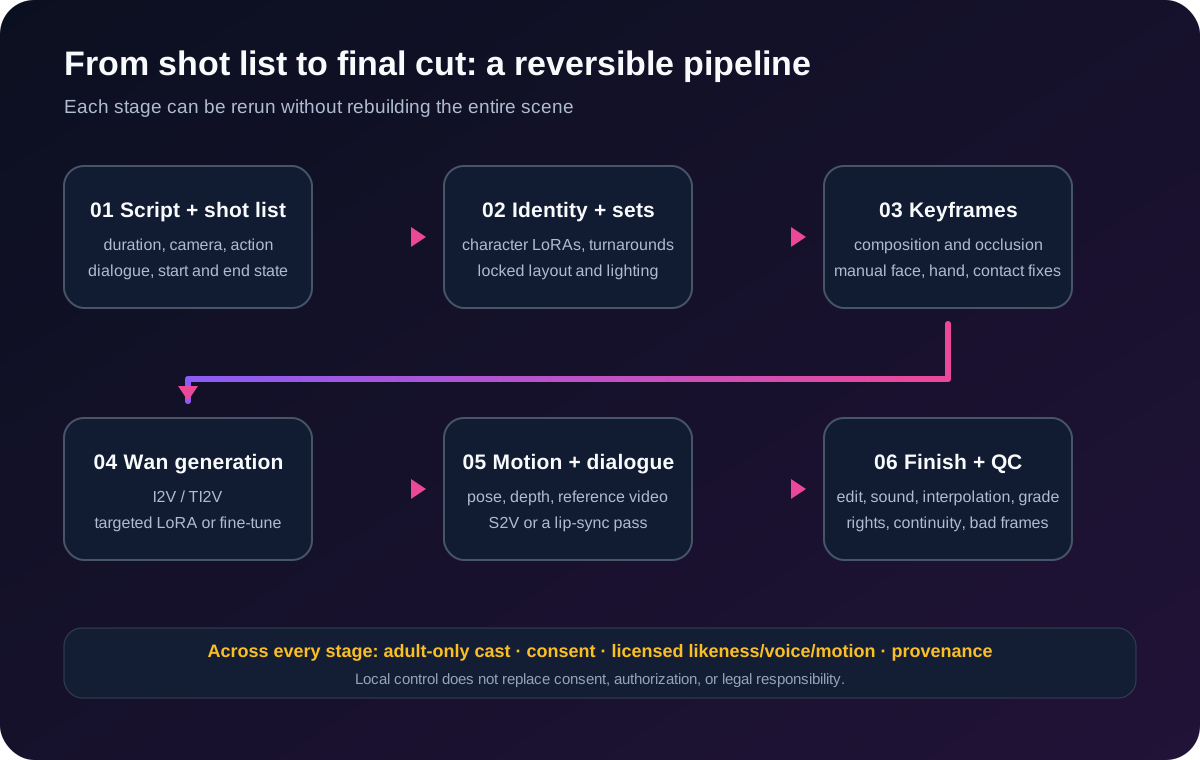
1. Transforme o script numa base de dados de produção
Um LLM pode ajudar a organizar o enredo, as relações, o diálogo e a ordem das cenas. O seu rascunho em prosa não é uma tarefa de renderização utilizável. Cada plano necessita de uma ID, cenário, elenco, enquadramento, posição da câmara, ação, emoção, diálogo, duração, estado de abertura, estado final, rota do modelo e qualquer movimento ou referência áudio necessária.
“Dois personagens completam uma interação complexa numa sala” é muito vago. A cena deve ser dividida em entrada, abordagem, reação, mudança de posição, detalhe e estado final. Isto torna as falhas diagnosticáveis: a composição, a identidade e o movimento já não colapsam no mesmo problema.
2. Reencaminhe o drama, o diálogo e a ação desafiadora separadamente
As notas de produção classificam os planos como narrativa regular, diálogo, conteúdo para adultos, movimento complexo, ambiente/transição ou finalização/efeitos visuais. Cada categoria recebe os seus próprios modelos, adaptadores, parâmetros de amostragem, referências e testes de aceitação. Uma predefinição universal parece eficiente até que novas tentativas e reparações apaguem o guardar.
3. Faça com que a personagem LoRA responda apenas “quem é?”
As personagens principais precisam de um pacote de identidade limpo: frente, perfil, vistas de três quartos, expressões, mudanças de iluminação, vistas de meio corpo e corpo inteiro e estados recorrentes de guarda-roupa. A idade, o formato do rosto, a maquilhagem e as proporções devem manter-se consistentes em todos os dados; caso contrário, o adaptador aprende uma média vaga.
A identidade e o movimento especializado são treinados separadamente. O adaptador de personagem estabelece quem está no quadro. Um adaptador de conteúdo ou movimento descreve o desempenho necessário. Esta modularidade permite ao estúdio substituir uma personagem sem treinar novamente toda a pilha de movimentos, ou melhorar o movimento sem alterar o rosto do artista.
Uma distinção técnica é importante: o lançamento oficial de Wan fornece pesos e código de inferência. A formação LoRA vem normalmente através de ferramentas como o DiffSynth-Studio, que o repositório oficial lista como uma integração da comunidade que suporta LoRA e formação completa. Não é um botão incorporado num produto Wan alojado.
4. Bloqueie conjuntos recorrentes antes da renderização
Quartos, salas de estar, hotéis e corredores precisam dos seus próprios pacotes de referência. As posições das portas e janelas, a orientação dos móveis, a luz principal, a temperatura da cor, o material da parede e as posições utilizáveis da câmara devem ser corrigidas. Quanto mais uma performance interage com camas, sofás ou paredes, mais óbvia se torna a deriva espacial. Um modelo definido é tanto uma referência de direção de arte como um sistema de coordenadas para o controlo posterior da pose e da profundidade.
Construa a imagem estática correta antes de pedir que se mova
As cenas narrativas regulares começam como fotogramas-chave aprovados. O still estabelece identidade, expressão, guarda-roupa, composição, luz, cenário e pose inicial. As fotografias mais complicadas também resolvem o número de caracteres, a posição relativa, a orientação do corpo, a oclusão, o contacto ambiental, o ângulo da câmara e o limite do enquadramento antes do início da geração do vídeo.
Cada fotograma-chave deve ser revisto manualmente. Rostos, olhos, mãos, ligações de membros, proporções, margens de roupas, contacto com móveis, reflexos, texto de fundo e objetos extra são mais baratos de corrigir uma vez na imagem de origem do que em dezenas de fotogramas de vídeo.
As três camadas de controlo para fotos especializadas
Camada 1: o fotograma-chave bloqueia a identidade, a pose e a câmara
Um modelo de imagem e adaptadores específicos criam a moldura de abertura aprovada. Esta camada responde quem está presente, onde está e como a cena é enquadrada. Deixa menos espaço para o modelo de vídeo redesenhar a relação entre os sujeitos.
Camada 2: Wan 2.2 I2V/TI2V lida com o tempo
O quadro aprovado entra numa rota Wan 2.2 I2V ou TI2V com os adaptadores direcionados ou o ajuste fino exigido por essa foto. Esta camada lida com a continuidade de movimento, retenção de identidade, persistência de textura, movimento de câmara e tempo. A documentação oficial de Wan diz que o TI2V-5B suporta texto para vídeo e imagem para vídeo em 720p e 24fps, e pode ser executado num GPU de consumo, como um RTX 4090.
Camada 3: as referências licenciadas descrevem como a ação se move
Os movimentos difíceis podem adicionar vídeos de referência autorizados, sequências de poses esqueléticas ou informações de profundidade. Estas entradas restringem a trajetória, velocidade, mudança de peso, orientação, distância e estado inicial/final. Os adaptadores de identidade controlam o executor; referências controlam o movimento; o modelo definido restringe o espaço. Separar estas responsabilidades reduz a troca de personagens, as intersecções corporais e o contacto instável.
Fotos regulares, diálogos e acabamento 24 a 30fps
Para fotos regulares, a editabilidade supera o espetáculo
Gere vários candidatos e, em seguida, verifica a identidade, a conformidade do storyboard, a linha dos olhos, a continuidade do guarda-roupa, a continuidade do conjunto e se os quadros maus podem ser cortados corretamente. Um plano contido que sobrevive do primeiro ao último fotograma é mais valioso do que um movimento de câmara ambicioso que sofre mutações a meio do caminho.
Diálogo: Wan-S2V ou um passe de sincronização labial separado
O projeto oficial Wan-S2V descreve um modelo que transforma uma imagem mais áudio em vídeo sincronizado com expressões naturais, movimento corporal e comportamento cinematográfico da câmara. Uma cena de diálogo útil ainda envolve mais do que formatos de boca. A respiração antes da fala, as pausas, o movimento dos olhos, a postura e a reação após a fala tornam a performance credível. Quando S2V não é o caminho certo, a equipa pode gerar primeiro a cena visual e aplicar a sincronização labial na pós.
24fps a 30fps: os quadros duplicados não são interpolação
As notas de produção dizem que os clipes de origem Wan foram gerados em 24fps e conformados com um mestre 30fps. Uma conversão de duplicação básica adiciona seis quadros de saída por segundo, ou um quadro repetido em cada cinco quadros de saída. Em vez disso, o fluxo ótico ou interpolação de IA cria quadros intermédios sintéticos e tem um padrão de artefactos diferente.
Qualquer um dos métodos necessita de revisão ao nível da cena. Mãos, cabelos, figuras sobrepostas e movimentos rápidos podem produzir novos erros estruturais entre fotogramas de origem utilizáveis. O acabamento incluiu também upscaling, eliminação de cintilação, remoção de ruído, correspondência de cores, correção de exposição, repintura local, remoção de quadros deficientes e estabilização de luz.
O som e a edição transformam os clipes 117 num único filme
Concluir a geração do vídeo significa apenas que a matéria-prima existe. O diálogo TTS, o ambiente, o som de ação, a música, as transições, a mistura, a redução de ruído e a normalização de volume criam continuidade auditiva. Legendas, gráficos de mensagens, interfaces de sistema, títulos e efeitos visuais restritos carregam a embalagem narrativa.
A edição final deve preservar a direção do ecrã, os olhos, o guarda-roupa, a iluminação definida, a ação no corte, a sincronização labial e o tempo do som, ao mesmo tempo que remove todos os fotogramas com falhas. AI produziu peças separadas 117. A edição fez com que parecessem uma curta-metragem de oito minutos.
Que hardware exige este fluxo de trabalho?
24GB VRAM: suficiente para validar, não necessariamente para entregar em escala
O comando TI2V-5B oficial de Wan pode ser executado com pelo menos 24GB de VRAM utilizando descarregamento de modelo, conversão de dtype e posicionamento de CPU para T5. Isto é útil para testes de caracteres, desenvolvimento de prompts, fotogramas-chave e clips limitados. Uma entrega de disparo 117 é um problema de rendimento: cada disparo aprovado pode ficar atrás de várias tentativas rejeitadas.
GPU duplo ou vários nós: as filas paralelas são mais importantes
NVIDIA lista 96GB de memória ECC GDDR7 e 600W potência máxima da placa para o RTX PRO 6000 Blackwell Workstation Edition. Duas placas representam, portanto, VRAM agregado 192GB e 1,200W de potência máxima da placa; quatro representam 384GB e 2,400W antes de CPU, armazenamento, memória e arrefecimento.
A VRAM agregada não é automaticamente um conjunto de memória partilhada. Duas placas 96GB não se comportam inerentemente como uma única placa 192GB. O software deve utilizar paralelismo de dados, paralelismo de modelo ou trabalhos de renderização separados para beneficiar. Para as tomadas 117, distribuir tarefas independentes por vários nós é muitas vezes mais flexível do que construir uma estação de trabalho extrema.
Lista de verificação de qualidade e direitos ao nível da filmagem
- Cada personagem retratada é explicitamente definida e apresentada como adulto.
- Rostos, vozes, referências de movimento e dados de treino têm autorização e proveniência documentadas.
- Nenhuma pessoa real aparece em conteúdo deepfake íntimo não consensual.
- A identidade, o rosto e a estrutura corporal correspondem ao design de personagem aprovado.
- Não existem membros fundidos, intersecções, anatomia inexplicável ou movimentos fisicamente incoerentes.
- O guarda-roupa, a geometria do cenário, a iluminação e a direção do ecrã continuam nas cenas adjacentes.
- A ginilação, as falhas de textura, o texto falso e os quadros interpolados destrutivos são removidos.
- O diálogo, a performance facial e o som de ação são sincronizados.
- A taxa de fotogramas, a resolução, a cor e o volume cumprem as especificações principais.
- A produção segue a lei e as regras da plataforma tanto nos locais de produção como de distribuição.
Perguntas frequentes
Porque é que Wan 2.2 é mais adequado para esta curta-metragem adulta de IA?
Não é automaticamente melhor para todos os filmes. Huangguo precisava de pesos para download, inferência local, ferramentas de treino externas e filas de espera autogeridas. Para conteúdo convencional em conformidade com as políticas, o fluxo de trabalho multimodal alojado do Seedance pode ser mais simples.
Porque não usar o Seedance?
O Seedance é oferecido publicamente como um serviço de geração alojada, e o Volcano Engine documenta verificações de segurança que incluem risco pornográfico. A sua interface pública também não expõe a pilha de treino do modelo base aos utilizadores finais. Isto torna-o incompatível com este canal específico de conteúdo para adultos, sem diminuir os seus pontos fortes para a produção cinematográfica comum.
Um filme de IA de oito minutos pode ser gerado numa passagem?
Atualmente, um fluxo de trabalho baseado em disparos é mais fácil de controlar e reparar. Huangguo usou planos revistos de forma independente por 117 e depois confiou na edição e no som para construir continuidade.
A difusão ou fluxo estável ainda importa?
Sim. Os modelos de imagem continuam a ser úteis para reviravoltas de caracteres, referências de conjuntos e fotogramas-chave. Os modelos de vídeo e pós-produção tratam de movimento, diálogo e continuidade temporal.
Os LoRAs de personagem e de conteúdo devem ser fundidos?
Geralmente não. Separar a identidade do movimento ou da capacidade de conteúdo facilita a substituição, o retreino e a depuração. O design final depende ainda do tamanho do conjunto de dados e do método de treino.
Um computador pessoal pode fazer isso?
Pode começar com TI2V-5B numa GPU 24GB. “Pode renderizar um clipe” e “pode entregar fotos aprovadas 117 dentro do cronograma” são limites diferentes, no entanto. O armazenamento, novas tentativas, gestão de filas e revisão humana tornam-se igualmente importantes.
A verdadeira barreira é uma linha de produção privada
O método Huangguo pode ser resumido da seguinte forma: estruturar a história como planos executáveis; bloquear a identidade com adaptadores de caracteres; mantenha o espaço com modelos definidos; aprovar quadros-chave; anime pequenos clips com Wan 2.2 e variantes direccionadas; orientar movimentos difíceis com referências licenciadas; encaminhar o diálogo através de S2V ou sincronização labial; em seguida, finalize o som, a cor, a interpolação e a edição numa linha de tempo 30fps.
Seedance representa uma poderosa geração de vídeo alojado. O Wan 2.2 fornece pesos, código de inferência e mais espaço para modificar o sistema. Para este projeto legal e autorizado – com ênfase na privacidade e na produção repetida de lotes – esta diferença foi decisiva. A comparação tem como objetivo ajudar os leitores a avaliar qual a rota que corresponde ao seu próprio conteúdo, orçamento, capacidade técnica e obrigações de conformidade, e não transmitir um “melhor modelo” universal.
Fontes oficiais
- Repositório oficial Wan 2.2: pesos, inferência, exemplos de hardware e integrações de treino comunitário
- Cartão modelo oficial Wan 2.2 TI2V-5B
- Página oficial do projeto Wan-S2V
- Visão geral oficial do ByteDance Seedance 2.0
- Estrutura de criação de segurança Seedance 2.0 do Volcano Engine
- Especificações oficiais NVIDIA RTX PRO 6000 Blackwell