La réponse courte : la partie intéressante de Huangguo ce n’est pas que l’IA soit impliquée. Le fait est que les cinéastes n’ont pas demandé à un modèle de créer un film de huit minutes à partir d’une seule invite. Selon les notes de production fournies pour cette étude de cas, ils ont divisé le film en plans courts 117 et ont contrôlé l'identité, les images clés, le mouvement, les dialogues et la finition comme des problèmes distincts. Wan 2.2 était la base parce que le projet avait besoin de poids locaux, d'un pipeline modifiable et d'une production par lots soutenue, et non pas parce que Seedance manque de qualité visuelle.
À propos des preuves : la durée d'exécution de huit minutes, le nombre de tirs 117, la durée médiane des tirs en secondes 3.2 et le processus spécifique au projet proviennent du matériel de production Huangguo fourni pour cet article. Les liens externes vérifient les capacités publiques Wan, Seedance, Wan-S2V et NVIDIA ; ces sociétés n'ont pas vérifié le journal de production privé du film.
Cet article couvre la production légale et basée sur le consentement impliquant uniquement des personnages clairement adultes. Il n’approuve pas les contenus ambigus en termes d’âge, les mineurs ou les deepfakes intimes non consensuels.
Pourquoi Wan 2.2 au lieu de Seedance ?
Seedance n’est pas le modèle faible dans cette comparaison. La page officielle de ByteDance met en évidence les références d'images, d'audio et de vidéo ainsi que le contrôle des performances, de l'éclairage et du mouvement de la caméra. Pour un projet conventionnel qui souhaite des capacités hébergées perfectionnées sans maintenir l’infrastructure locale, cela peut constituer un avantage majeur.
Huangguo avait un ensemble de contraintes différent. Plus d'une centaine de clichés ont nécessité un échantillonnage répété. L'identité, le mouvement et le dialogue des personnages ont dû être ajustés indépendamment. Un tir raté devait être récupérable à n'importe quelle étape. Le studio devait également posséder ses actifs de formation et sa file d'attente de génération. Wan 2.2 publie des poids de modèle et un code d'inférence, avec des chemins T2V, I2V, TI2V et S2V qui peuvent être intégrés dans un système de rendu privé.
| Exigence de production | Flux de travail Wan 2.2 local | Service public de semis |
|---|---|---|
| Accès au modèle | Poids et code d'inférence téléchargeables | Capacité terminée via des produits hébergés ou des API |
| Inférence locale | Instructions officielles de course locale | La page de modèle publique ne propose pas de poids de base téléchargeables |
| LoRA et formations ciblées | Peut se connecter aux outils communautaires LoRA/de formation complète | La pile de formation du modèle de base n'est pas exposée via l'interface publique |
| Production par lots | Files d'attente, caches et planification multi-nœuds autogérés | Soumis aux quotas d'API, aux tarifs et aux règles de service |
| Contenu pour adultes | Exécution locale ; le producteur reste responsable de la loi, du consentement et de la sécurité | Volcano Engine déclare que son système de sécurité détecte et bloque le risque pornographique |
| Meilleur ajustement | Ligne de production privée formable et réversible | Génération multimodale pratique pour un travail conforme aux politiques |
Il s’agit d’une décision de flux de travail et non d’un classement universel de la qualité d’image. Seedance offre un service géré solide. Huangguo avait besoin de s'approprier les poids, les données et la logique de planification. La propre page de création de sécurité de Volcano Engine indique également que sa plate-forme contrôle les entrées et sorties clairement non conformes, avec une attention particulière au risque pornographique, ce qui l'exclut en tant que générateur central dans cette affaire.
Pourquoi diviser huit minutes en plans 117 ?
Les générations plus longues multiplient le nombre de choses qui peuvent dériver : visages, mains, vêtements, géométrie de l'arrière-plan, contact entre les personnages, éclairage et mouvements de caméra. Une petite erreur dans une interaction complexe peut s’aggraver en quelques secondes. Les plans courts ne sont pas automatiquement plus rapides ; ils rendent chaque rendu testable.
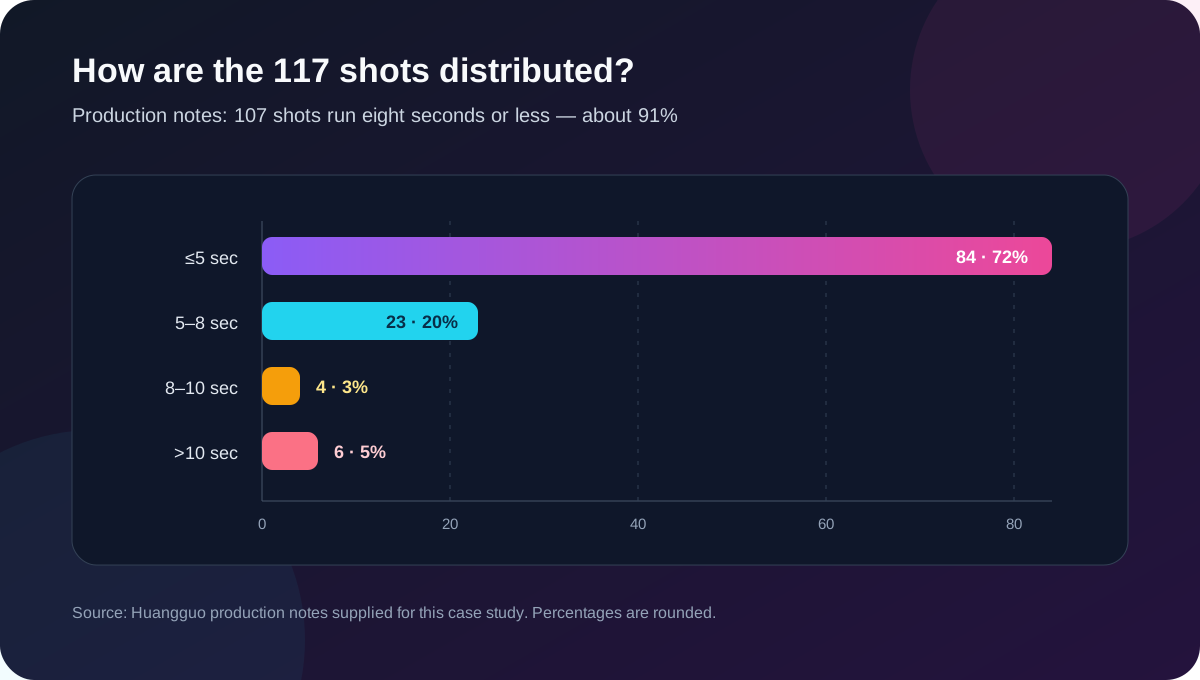
Un plan de trois à huit secondes peut se voir attribuer une tâche : une ligne de regard, un virage, une phrase, une phase de mouvement, un changement d'angle ou un insert de détail. Des scènes complexes peuvent être reconstruites à partir de plans larges, de gros plans, d'inserts et de réactions. Le sentiment de performance continue est créé lors du montage au lieu d’être exigé d’une seule génération.
La chaîne de production démarre avec des plans exécutables
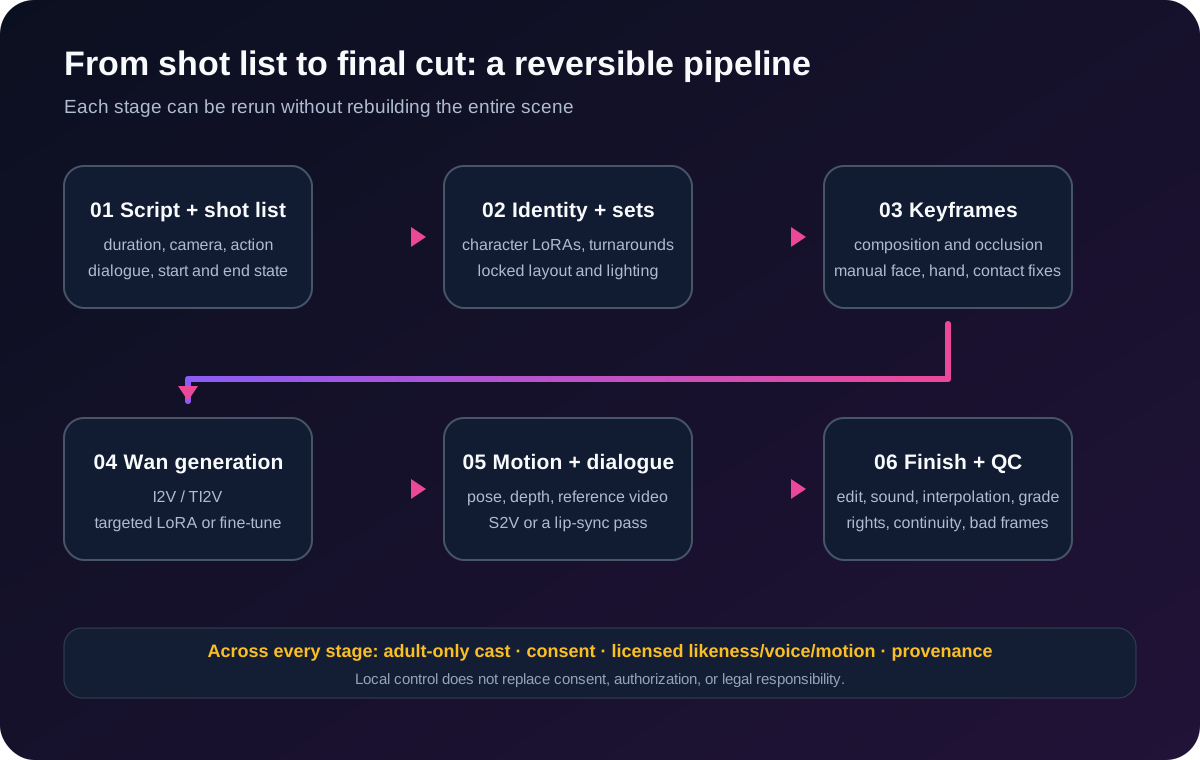
1. Transformez le script en base de données de production
Un LLM peut aider à organiser l'intrigue, les relations, le dialogue et l'ordre des scènes. Son brouillon de prose n'est pas une tâche de rendu utilisable. Chaque plan nécessite une identification, un décor, une distribution, un cadrage, une position de la caméra, une action, une émotion, un dialogue, une durée, un état d'ouverture, un état final, un itinéraire modèle et tout mouvement ou référence audio requis.
« Deux personnages complètent une interaction complexe dans une pièce » est trop vague. La scène doit être divisée en entrée, approche, réaction, changement de position, détail et état final. Cela rend les échecs diagnostiquables : la composition, l’identité et le mouvement ne se résument plus au même problème.
2. Acheminez séparément le drame, les dialogues et les mouvements difficiles
Les notes de production classent les plans en narration régulière, dialogue, contenu pour adultes, mouvement complexe, environnement/transition ou finition/VFX. Chaque catégorie possède ses propres modèles, adaptateurs, paramètres d'échantillonnage, références et tests d'acceptation. Un préréglage universel semble efficace jusqu'à ce que les tentatives et les réparations effacent la sauvegarde.
3. Faites en sorte que le personnage LoRA réponde uniquement « qui est-ce ? »
Les personnages principaux ont besoin d'un pack d'identité propre : vues de face, de profil, de trois quarts, expressions, changements d'éclairage, vues de la moitié du corps et de tout le corps et états de garde-robe récurrents. L'âge, la forme du visage, le maquillage et les proportions doivent rester cohérents dans toutes les données ; sinon l'adaptateur apprend une vague moyenne.
L'identité et le mouvement spécialisé sont formés séparément. L'adaptateur de caractères détermine qui est dans le cadre. Un adaptateur de contenu ou de mouvement décrit les performances requises. Cette modularité permet au studio de remplacer un personnage sans recycler l'intégralité de la pile de mouvements, ou d'améliorer les mouvements sans changer le visage de l'interprète.
Une distinction technique est importante : la version officielle de Wan fournit des poids et un code d'inférence. La formation LoRA s'effectue généralement via des outils tels que DiffSynth-Studio, que le référentiel officiel répertorie comme une intégration communautaire prenant en charge LoRA et une formation complète. Il ne s'agit pas d'un bouton intégré à un produit Wan hébergé.
4. Verrouiller les ensembles récurrents avant le rendu
Les chambres à coucher, les salons, les hôtels et les couloirs ont besoin de leurs propres packs de référence. Les positions des portes et des fenêtres, l’orientation des meubles, l’éclairage des touches, la température de couleur, le matériau des murs et les positions utilisables des caméras doivent être corrigés. Plus une performance interagit avec les lits, les canapés ou les murs, plus la dérive spatiale devient évidente. Un modèle défini est à la fois une référence de direction artistique et un système de coordonnées pour un contrôle ultérieur de la pose et de la profondeur.
Créez l'image fixe correcte avant de lui demander de bouger
Les plans narratifs réguliers commencent comme des images clés approuvées. L'image fixe l'identité, l'expression, la garde-robe, la composition, la lumière, le décor et la pose de départ. Des prises de vue plus complexes résolvent également le nombre de caractères, la position relative, l'orientation du corps, l'occlusion, le contact avec l'environnement, l'angle de la caméra et les limites de l'image avant le début de la génération vidéo.
Chaque image clé doit être examinée manuellement. Les visages, les yeux, les mains, les connexions des membres, les proportions, les bords des vêtements, le contact avec les meubles, les reflets, le texte d'arrière-plan et les objets supplémentaires sont moins coûteux à corriger une fois dans l'image source que sur des dizaines d'images vidéo.
Les trois couches de contrôle pour les prises de vue spécialisées
Calque 1 : l'image clé verrouille l'identité, la pose et la caméra
Un modèle d'image et des adaptateurs spécialement conçus créent le cadre d'ouverture approuvé. Cette couche répond qui est présent, où ils se trouvent et comment la scène est cadrée. Cela laisse moins de place au modèle vidéo pour redessiner les relations entre les sujets.
Couche 2 : Wan 2.2 I2V/TI2V gère le temps
Le cadre approuvé entre dans un itinéraire Wan 2.2 I2V ou TI2V avec les adaptateurs ciblés ou les réglages fins requis par cette prise de vue. Cette couche gère la continuité du mouvement, la conservation de l'identité, la persistance des textures, le mouvement de la caméra et le timing. La documentation officielle de Wan indique que TI2V-5B prend en charge à la fois la conversion texte-vidéo et l'image-vidéo à 720p et 24fps, et peut fonctionner sur un GPU grand public tel qu'un RTX 4090.
Couche 3 : les références sous licence décrivent le déroulement de l'action
Un mouvement difficile peut ajouter une vidéo de référence autorisée, des séquences de poses squelettiques ou des informations sur la profondeur. Ces entrées contraignent la trajectoire, la vitesse, le transfert de poids, l'orientation, la distance et l'état de début/fin. Les adaptateurs d'identité contrôlent l'interprète ; les références contrôlent le mouvement ; le modèle défini limite l'espace. Séparer ces responsabilités réduit les changements de personnage, les intersections de corps et les contacts instables.
Prises de vue régulières, dialogues et finition 24 à 30fps
Pour les prises de vue régulières, la possibilité de montage bat le spectacle
Générez plusieurs candidats, puis vérifiez l'identité, la conformité du storyboard, la ligne des yeux, la continuité de la garde-robe, la continuité du décor et si les mauvais cadres peuvent être coupés proprement. Un plan retenu qui survit de la première image à la dernière a plus de valeur qu'un mouvement de caméra ambitieux qui mute à mi-parcours.
Dialogue : Wan-S2V ou une passe de synchronisation labiale séparée
Le projet officiel Wan-S2V décrit un modèle qui transforme une image plus audio en vidéo synchronisée avec des expressions naturelles, des mouvements du corps et un comportement de caméra cinématographique. Un plan de dialogue utile implique toujours plus que la forme de la bouche. La respiration avant le discours, les pauses, les mouvements des yeux, la posture et la réaction après la réplique rendent la performance crédible. Lorsque S2V n'est pas la bonne voie, l'équipe peut d'abord générer la prise de vue visuelle et appliquer la synchronisation labiale en post.
24fps à 30fps : les images dupliquées ne sont pas interpolées
Les notes de production indiquent que les clips sources Wan ont été générés à 24fps et conformes à un master 30fps. Une conversion de duplication de base ajoute six images de sortie par seconde, soit une image répétée toutes les cinq images de sortie. L'interpolation de flux optique ou d'IA crée à la place des images synthétiques intermédiaires et présente un modèle d'artefact différent.
L’une ou l’autre méthode nécessite un examen au niveau du plan. Les mains, les cheveux, les personnages qui se chevauchent et les mouvements rapides peuvent produire de nouvelles erreurs structurelles entre des images sources autrement utilisables. La finition comprenait également la mise à l'échelle, l'élimination du scintillement, le débruitage, la correspondance des couleurs, la correction de l'exposition, la repeinture locale, la suppression des mauvaises images et la stabilisation de la lumière.
Le son et le montage transforment les clips 117 en un seul film
Terminer la génération vidéo signifie uniquement que la matière première existe. Le dialogue TTS, l'ambiance, le son d'action, la musique, les transitions, le mixage, la réduction du bruit et la normalisation du volume créent une continuité auditive. Les sous-titres, les graphiques de messagerie, les interfaces système, les titres et les effets visuels sobres portent l'emballage narratif.
Le montage final doit préserver la direction de l'écran, les lignes des yeux, la garde-robe, l'éclairage défini, l'action lors du montage, la synchronisation labiale et le timing du son tout en supprimant chaque image ratée. AI a produit des pièces séparées 117. Le montage leur donnait l’impression d’être un court métrage de huit minutes.
Quel matériel ce flux de travail nécessite-t-il ?
24GB VRAM : suffisante pour valider, pas nécessairement pour livrer à grande échelle
La commande officielle TI2V-5B de Wan peut s'exécuter avec au moins 24GB de VRAM en utilisant le déchargement de modèle, la conversion de type et le placement du processeur pour T5. Ceci est utile pour les tests de personnages, le développement rapide, les images clés et les clips limités. Une livraison de 117-shots est un problème de débit : chaque shot approuvé peut se trouver derrière plusieurs tentatives rejetées.
Double GPU ou plusieurs nœuds : les files d'attente parallèles sont les plus importantes
NVIDIA répertorie 96GB de mémoire GDDR7 ECC et 600W de puissance maximale de la carte pour le RTX PRO 6000 Blackwell Workstation Edition. Deux cartes représentent donc 192GB de VRAM cumulée et 1,200W de puissance maximale de la carte ; quatre représentent 384GB et 2,400W avant le processeur, le stockage, la mémoire et le refroidissement.
La VRAM agrégée ne constitue pas automatiquement un pool de mémoire partagée. Deux cartes 96GB ne se comportent pas intrinsèquement comme une seule carte 192GB. Pour en bénéficier, le logiciel doit utiliser le parallélisme des données, le parallélisme des modèles ou des tâches de rendu distinctes. Pour les prises de vue 117, la répartition des tâches indépendantes sur plusieurs nœuds est souvent plus flexible que la création d'un seul poste de travail extrême.
Liste de contrôle de la qualité et des droits au niveau du plan
- Chaque personnage représenté est explicitement défini et présenté comme un adulte.
- Les visages, les voix, les références de mouvement et les données d'entraînement ont une autorisation et une provenance documentées.
- Aucune personne réelle n’apparaît dans le contenu deepfake intime non consensuel.
- L'identité, le visage et la structure du corps correspondent à la conception du personnage approuvée.
- Il n’y a pas de membres fusionnés, d’intersections, d’anatomie inexpliquée ou de mouvement physiquement incohérent.
- La garde-robe, la géométrie définie, l'éclairage et la direction de l'écran se poursuivent sur les plans adjacents.
- Le scintillement, les défauts de texture, le faux texte et les images interpolées destructrices sont supprimés.
- Les dialogues, les performances faciales et le son de l'action sont synchronisés.
- La fréquence d'images, la résolution, la couleur et le volume sonore répondent aux spécifications principales.
- La production respecte la loi et les règles de la plateforme, tant sur les sites de production que de distribution.
Questions fréquemment posées
Pourquoi Wan 2.2 convient-il mieux à ce court métrage sur l'IA pour adultes ?
Ce n’est pas automatiquement meilleur pour chaque film. Huangguo avait besoin de poids téléchargeables, d'inférences locales, d'outils de formation externes et de files d'attente autogérées. Pour le contenu conventionnel conforme aux politiques, le flux de travail multimodal hébergé de Seedance peut être plus simple.
Pourquoi ne pas utiliser Seedance ?
Seedance est proposé publiquement en tant que service de génération hébergé, et Volcano Engine documente les contrôles de sécurité qui incluent le risque pornographique. Son interface publique n'expose pas non plus la pile de formation du modèle de base aux utilisateurs finaux. Cela le rend incompatible avec ce pipeline particulier de contenu pour adultes, sans pour autant diminuer ses atouts pour le cinéma ordinaire.
Un film IA de huit minutes peut-il être généré en un seul passage ?
Un flux de travail basé sur les prises de vue est actuellement plus facile à contrôler et à réparer. Huangguo a utilisé 117 des plans examinés de manière indépendante, puis s'est appuyé sur le montage et le son pour assurer la continuité.
La diffusion ou le flux stable sont-ils toujours importants ?
Oui. Les modèles d'image restent utiles pour les retournements de personnages, les références définies et les images clés. Les modèles vidéo et la post-production gèrent le mouvement, le dialogue et la continuité temporelle.
Les LoRA de personnage et de contenu doivent-elles être fusionnées ?
Généralement non. Séparer l'identité des capacités de mouvement ou de contenu facilite le remplacement, le recyclage et le débogage. La conception finale dépend toujours de la taille de l'ensemble de données et de la méthode de formation.
Un ordinateur personnel peut-il faire cela ?
Il peut commencer par TI2V-5B sur un GPU 24GB. « Peut restituer un clip » et « peut fournir des plans approuvés 117 dans les délais » sont cependant des seuils différents. Le stockage, les tentatives, la gestion des files d’attente et l’examen humain deviennent tout aussi importants.
Le véritable obstacle est une chaîne de production privée
La méthode Huangguo peut être résumée comme suit : structurer l'histoire sous forme de plans exécutables ; verrouiller l'identité avec des adaptateurs de caractères ; conserver l'espace avec des modèles définis ; approuver les images clés ; animer de courts clips avec Wan 2.2 et des variantes ciblées ; guider les mouvements difficiles avec des références agréées ; acheminer le dialogue via S2V ou lip sync ; puis terminez le son, la couleur, l'interpolation et le montage sur une timeline 30fps.
Seedance représente une puissante génération de vidéos hébergées. Wan 2.2 fournit des poids, un code d'inférence et plus d'espace pour modifier le système. Pour ce projet légal et autorisé – qui met l’accent sur la confidentialité et la production par lots répétés – cette différence a été décisive. La comparaison est destinée à aider les lecteurs à juger quel itinéraire correspond à leur propre contenu, leur budget, leurs compétences techniques et leurs obligations de conformité, et non à transmettre un « meilleur modèle » universel.
Sources officielles
- Dépôt officiel Wan 2.2 : pondérations, inférences, exemples de matériel et intégrations de formation communautaire
- Carte modèle officielle Wan 2.2 TI2V-5B
- Page officielle du projet Wan-S2V
- Présentation officielle de ByteDance Seedance 2.0
- Cadre de création de sécurité Seedance 2.0 de Volcano Engine
- Spécifications officielles de NVIDIA RTX PRO 6000 Blackwell