간단한 답: 의 흥미로운 부분 황궈 AI가 관련되지 않았던 것이 아니다. 문제는 영화 제작자들이 한 가지 프롬프트로 8분짜리 영화를 만들기 위해 하나의 모델에 의존하지 않았다는 것이다. 이 사례 연구를 위해 제공된 제작 노트에 따르면, 그들은 영화를 117개의 짧은 샷으로 나누고, 아이덴티티, 키프레임, 모션, 대사, 후반 작업을 별개의 문제로 관리했다. Wan 2.2가 기반이 된 이유는 이 프로젝트가 로컬 가중치, 수정 가능한 파이프라인, 지속적인 배치 제작을 필요로 했기 때문이지, Seedance가 시각적 품질이 부족했기 때문이 아니다.
증거에 대하여: 8분 러닝타임, 117개의 샷 수, 3.2초의 중간 샷 길이, 그리고 프로젝트별 프로세스는 이 글을 위해 제공된 황궈(Huangguo) 제작 자료에서 나온 것입니다. 외부 링크는 공용 Wan, Seedance, Wan-S2V, 그리고 NVIDIA의 능력을 확인할 수 있지만, 해당 회사들은 영화의 비공개 제작 기록을 검증하지 않았습니다.
이 글은 명확히 성인 캐릭터만을 포함한 합법적이고 동의에 기반한 제작을 다룹니다. 연령이 애매한 콘텐츠, 미성년자, 또는 비동의 친밀 딥페이크를 지지하지 않습니다.
왜 시던스 대신 Wan 2.2인가요?
Seedance는 이 비교에서 약한 모델이 아닙니다. ByteDance의 공식 페이지는 이미지, 오디오, 비디오 자료와 공연, 조명, 카메라 움직임에 대한 제어 기능을 강조하고 있습니다. 로컬 인프라를 유지하지 않고도 세련된 호스팅 기능을 원하는 일반적인 프로젝트에는 이것이 큰 장점이 될 수 있습니다.
황궈에는 다른 제약 조건 세트가 있었습니다. 100회 이상의 샷에는 반복 샘플링이 필요했습니다. 캐릭터의 정체성, 움직임, 대사는 독립적으로 조정되어야 했습니다. 실패한 샷은 어느 단계에서든 복구할 수 있어야 했습니다. 스튜디오는 또한 자체 학습 자산과 생성 큐를 소유해야 했습니다. Wan 2.2는 모델 가중치와 추론 코드를 게시하며, T2V, I2V, TI2V, S2V 경로가 개인 렌더링 시스템에 통합될 수 있습니다.
| 생산 요구 사항 | 로컬 WAN 2.2 워크플로 | 공공 시댄스 서비스 |
|---|---|---|
| 모델 접근 | 다운로드 가능한 가중치 및 추론 코드 | 호스팅된 제품 또는 API를 통한 완료된 기능 |
| 로컬 추론 | 공식 로컬 실행 지침 | 공개 모델 페이지에서는 다운로드 가능한 기본 가중치를 제공하지 않습니다 |
| LoRA와 타겟 훈련 | 커뮤니티 LoRA/전체 학습 도구에 연결할 수 있음 | 기본 모델 훈련 스택은 공개 인터페이스를 통해 노출되지 않습니다 |
| 배치 생산 | 자가 관리 큐, 캐시, 멀티 노드 스케줄링 | API 할당량, 가격 및 서비스 규칙에 따릅니다 |
| 성인용 콘텐츠 | 현지 실행; 제작자는 법률, 동의 및 안전에 대해 계속 책임을 집니다 | 볼케이노 엔진은 자사의 안전 시스템이 포르노 위험을 감지하고 차단한다고 명시합니다 |
| 최적의 적합 | 훈련 가능하고 가역적인 개인 생산 라인 | 정책 준수를 위한 편리한 멀티모달 생성 |
이것은 워크플로 결정이지, 보편적인 이미지 품질 순위가 아닙니다. Seedance는 강력한 관리형 서비스를 제공합니다. Huangguo는 가중치, 데이터, 스케줄링 로직에 대한 소유권이 필요했습니다. Volcano Engine의 자체 안전 생성 페이지에서도 그 플랫폼이 명백히 준수되지 않는 입력과 출력을 통제하며, 특히 포르노 위험에 주의한다고 명시되어 있어, 이 사례의 중앙 생성기로는 제외됩니다.
왜 8분을 117개의 장면으로 나누나요?
더 긴 세대는 표정, 손, 옷, 배경 구조, 캐릭터 간의 접촉, 조명, 카메라 움직임 등 떠돌 수 있는 것들의 수를 늘립니다. 복잡한 상호작용에서의 작은 실수는 몇 초 동안 누적될 수 있습니다. 짧은 샷이 자동으로 속도감 있는 것은 아니며, 각 렌더를 테스트할 수 있게 만듭니다.
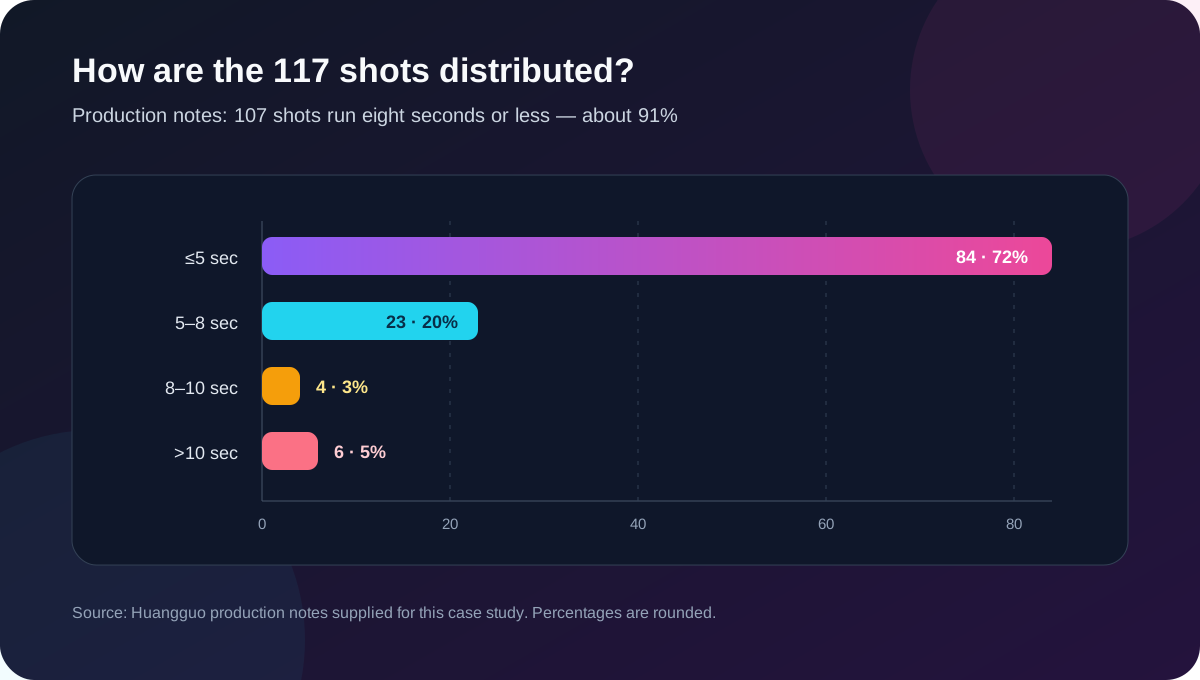
3초에서 8초 길이의 장면은 한 가지 작업에 할당될 수 있다: 시선, 회전, 한 문장, 한 동작 단계, 앵글의 변화, 또는 디테일 삽입. 복잡한 장면은 와이드 샷, 클로즈업, 삽입, 반응 장면에서 재구성될 수 있다. 연속적인 연기의 느낌은 한 세대로부터 요구되는 것이 아니라 편집에서 만들어진다.
생산 라인은 실행 가능한 샷으로 시작합니다
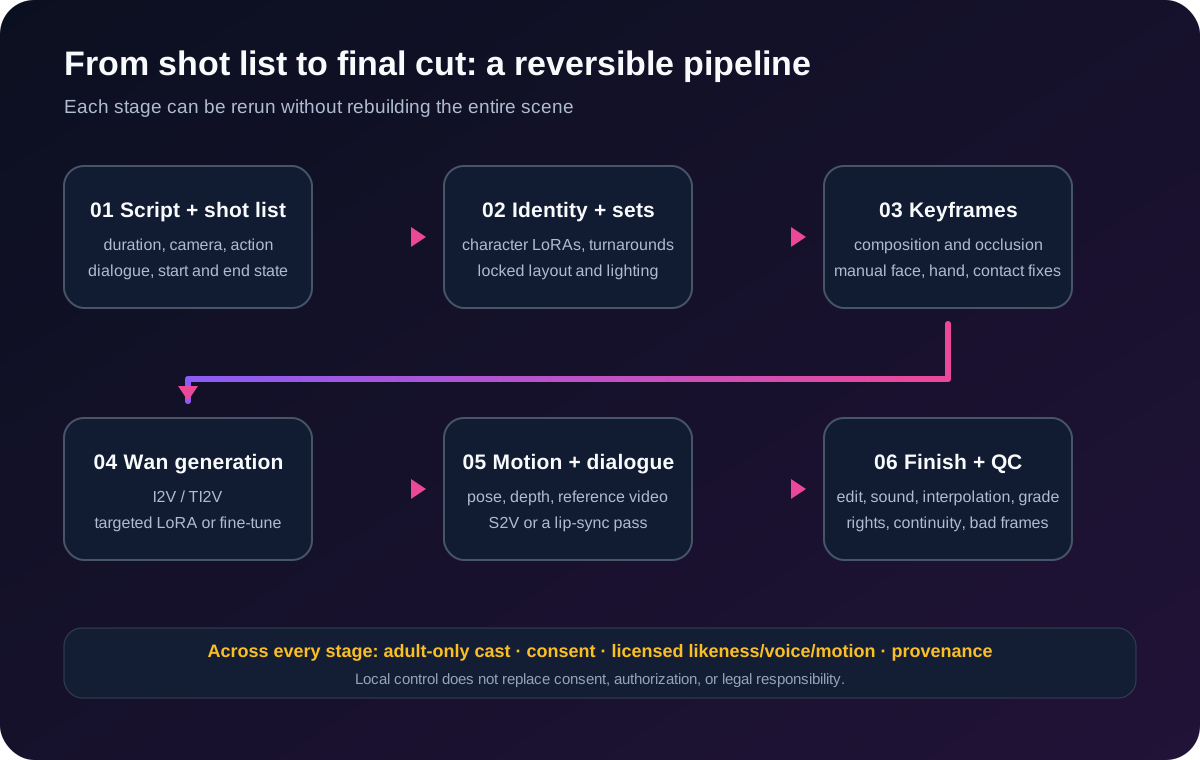
1. 스크립트를 프로덕션 데이터베이스로 바꾸세요
LLM은 줄거리, 관계, 대화, 장면 순서를 정리하는 데 도움이 될 수 있습니다. 그것의 산문 초안은 사용 가능한 렌더링 작업이 아닙니다. 각 샷은 ID, 세트, 출연진, 구도, 카메라 위치, 행동, 감정, 대사, 지속 시간, 시작 상태, 종료 상태, 모델 경로, 그리고 필요한 움직임 또는 오디오 참조를 포함해야 합니다.
“두 캐릭터가 방에서 복잡한 상호작용을 한다”는 너무 모호합니다. 장면은 입장, 접근, 반응, 위치 변화, 세부 사항, 그리고 최종 상태로 나누어져야 합니다. 그렇게 하면 실패 원인을 진단할 수 있습니다: 구성, 정체성, 움직임이 더 이상 같은 문제로 합쳐지지 않습니다.
2. 루트 드라마, 대화, 그리고 어려운 동작을 각각 구분하세요
제작 노트에서는 촬영 장면을 일반 내러티브, 대화, 성인 콘텐츠, 복잡한 동작, 환경/전환, 또는 마무리/VFX로 분류합니다. 각 카테고리는 자체 모델, 어댑터, 샘플링 매개변수, 참조 및 승인 테스트를 가지게 됩니다. 하나의 보편적인 프리셋은 효율적처럼 보이지만 재시도와 수리가 그 절약을 없애버립니다.
3. 캐릭터 LoRA가 '이 사람 누구야?'라고만 대답하게 하세요.
주인공 캐릭터는 깔끔한 정체성 패키지가 필요합니다: 정면, 옆모습, 3/4 뷰, 표정, 조명 변화, 상반신 및 전신 뷰, 반복되는 의상 상태. 연령, 얼굴형, 메이크업, 비율은 데이터 전반에 걸쳐 일관되어야 합니다. 그렇지 않으면 어댑터가 애매한 평균을 학습하게 됩니다.
정체성과 전문화된 동작은 별도로 훈련됩니다. 캐릭터 어댑터는 누가 화면에 있는지를 결정합니다. 콘텐츠 또는 동작 어댑터는 요구되는 수행을 설명합니다. 이러한 모듈성은 스튜디오가 전체 동작 스택을 재훈련하지 않고도 캐릭터를 교체하거나, 수행자의 얼굴을 변경하지 않고도 동작을 개선할 수 있게 합니다.
한 가지 기술적인 차이가 중요합니다: Wan의 공식 릴리스는 가중치와 추론 코드를 제공합니다. LoRA 훈련은 일반적으로 DiffSynth-Studio와 같은 도구를 통해 이루어지며, 공식 리포지토리는 이를 LoRA와 전체 훈련을 지원하는 커뮤니티 통합으로 나열하고 있습니다. 이는 호스팅된 Wan 제품에 내장된 버튼이 아닙니다.
4. 렌더링하기 전에 반복 세트를 잠그기
침실, 거실, 호텔, 복도는 고유한 참조 팩이 필요하다. 문과 창문의 위치, 가구 배치, 키 라이트, 색온도, 벽 재질, 사용 가능한 카메라 위치는 고정되어야 한다. 공연이 침대, 소파, 벽과 많이 상호작용할수록 공간의 일탈이 더 뚜렷해진다. 정해진 템플릿은 이후 포즈와 깊이 제어를 위한 미술 지시 참조이자 좌표 시스템이다.
움직이게 하기 전에 올바른 정지 이미지를 만드세요
일반적인 내러티브 촬영은 승인된 키프레임으로 시작합니다. 정지는 정체성, 표정, 의상, 구도, 조명, 세트, 시작 포즈를 설정합니다. 보다 복잡한 촬영은 또한 비디오 생성이 시작되기 전에 등장인물 수, 상대적 위치, 신체 방향, 가림, 환경과의 접촉, 카메라 각도, 프레임 경계를 해결합니다.
모든 키프레임은 수동으로 검토해야 합니다. 얼굴, 눈, 손, 사지 연결, 비율, 의복 가장자리, 가구 접촉, 반사, 배경 텍스트, 추가 객체는 수십 개의 비디오 프레임에 걸쳐 수정하는 것보다 원본 이미지에서 한 번에 수정하는 것이 더 저렴합니다.
특수 촬영을 위한 세 가지 제어 층
레이어 1: 키프레임이 아이덴티티, 포즈 및 카메라를 고정합니다
목적에 맞게 제작된 이미지 모델과 어댑터가 승인된 오프닝 프레임을 생성합니다. 이 레이어는 누가 있는지, 그들이 어디에 있는지, 그리고 장면이 어떻게 구성되어 있는지를 답합니다. 이는 비디오 모델이 피사체 간의 관계를 재설계할 여지를 줄입니다.
레이어 2: WAN 2.2 I2V/TI2V는 시간을 처리합니다
승인된 프레임은 해당 샷에 필요한 대상 어댑터 또는 세분화 조정과 함께 Wan 2.2 I2V 또는 TI2V 경로에 진입합니다. 이 레이어는 모션 연속성, 정체성 유지, 질감 지속성, 카메라 움직임 및 타이밍을 처리합니다. Wan의 공식 문서에 따르면 TI2V-5B는 720p 및 24fps에서 텍스트-투-비디오와 이미지-투-비디오를 모두 지원하며, RTX 4090과 같은 소비자 GPU에서 실행할 수 있습니다.
레이어 3: 면허가 있는 참고 문헌은 동작이 어떻게 이동하는지 설명합니다
어려운 동작은 승인된 참조 비디오, 골격 포즈 시퀀스 또는 깊이 정보를 추가할 수 있습니다. 이러한 입력은 궤적, 속도, 체중 이동, 방향, 거리 및 시작/종료 상태를 제한합니다. 정체성 어댑터는 수행자를 제어하고, 참조는 동작을 제어하며, 설정 템플릿은 공간을 제한합니다. 이러한 책임을 분리하면 캐릭터 전환, 신체 교차 및 불안정한 접촉을 줄일 수 있습니다.
정기적인 샷, 대화, 그리고 24~30fps 마감
일반 촬영에서는 장관보다 편집 가능성이 더 중요하다
여러 후보를 생성한 다음, 신원, 스토리보드 준수 여부, 시선 방향, 의상 연속성, 세트 연속성, 나쁜 프레임이 깔끔하게 잘릴 수 있는지 여부를 확인하세요. 처음 프레임부터 마지막 프레임까지 살아남는 절제된 샷이, 중간에 변화하는 야심찬 카메라 이동보다 더 가치가 있습니다.
대화: Wan-S2V 또는 별도의 립싱크 패스
공식 Wan-S2V 프로젝트는 하나의 이미지와 오디오를 자연스러운 표정, 몸의 움직임, 영화적인 카메라 동작과 함께 동기화된 영상으로 변환하는 모델을 설명합니다. 유용한 대화 장면은 단순한 입 모양 이상의 것을 포함합니다. 말하기 전의 숨, 일시정지, 눈의 움직임, 자세, 대사 후의 반응이 연기를 믿을 수 있게 만듭니다. S2V가 적절하지 않은 경우, 팀은 시각적 장면을 먼저 생성하고 이후에 립싱크를 적용할 수 있습니다.
24fps에서 30fps로: 중복된 프레임은 보간이 아닙니다
제작 노트에 따르면 Wan 소스 클립은 24fps로 생성되었고 30fps 마스터에 맞춰졌습니다. 기본적인 중복 변환은 초당 6 프레임을 추가하며, 즉 출력되는 5 프레임마다 1 프레임이 반복됩니다. 광학 흐름(optical-flow) 또는 AI 보간은 대신 합성된 중간 프레임을 생성하며 다른 종류의 아티팩트 패턴을 가집니다.
어느 방법이든 샷 단위 검토가 필요합니다. 손, 머리카락, 겹친 인물, 빠른 움직임은 그렇지 않으면 사용 가능한 소스 프레임 사이에 새로운 구조적 오류를 발생시킬 수 있습니다. 마무리에는 업스케일링, 플리커 제거, 노이즈 제거, 색상 매칭, 노출 보정, 국소 리페인팅, 불량 프레임 제거, 조명 안정화도 포함되었습니다.
사운드와 편집이 117개의 클립을 하나의 영화로 만든다
비디오 생성만 완료된다는 것은 원자재가 존재한다는 것을 의미합니다. TTS 대화, 환경음, 행동 소리, 음악, 전환 효과, 믹싱, 잡음 제거 및 음량 정규화는 청각적 연속성을 만듭니다. 자막, 메시징 그래픽, 시스템 인터페이스, 타이틀, 절제된 VFX는 내러티브 포장을 전달합니다.
최종 편집은 실패한 모든 프레임을 제거하면서도 화면 방향, 시선, 의상, 세트 조명, 컷에서의 동작, 립싱크, 사운드 타이밍을 유지해야 합니다. AI는 117개의 개별 조각을 제작했습니다. 편집을 통해 그것들을 8분짜리 단편처럼 느껴지게 만들었습니다.
이 워크플로우에는 어떤 하드웨어가 필요합니까?
24GB VRAM: 검증에는 충분하지만, 대규모로 제공하기에는 반드시 충분하지는 않음
완의 공식 TI2V-5B 명령은 모델 오프로드, dtype 변환, T5용 CPU 배치를 사용하여 최소 24GB VRAM으로 실행할 수 있습니다. 이는 캐릭터 테스트, 프롬프트 개발, 키프레임, 제한된 클립에 유용합니다. 117샷의 전달은 처리량 문제입니다: 승인된 각 샷은 여러 번 거부된 시도 뒤에 있을 수 있습니다.
듀얼 GPU 또는 다중 노드: 병렬 큐가 가장 중요합니다
NVIDIA는 RTX PRO 6000 Blackwell Workstation Edition에 대해 96GB GDDR7 ECC 메모리와 최대 600W 보드 전력을 나열하고 있습니다. 따라서 두 개의 카드는 총 192GB VRAM과 최대 1,200W의 보드 전력을 나타내며, 네 개의 카드는 CPU, 저장 장치, 메모리 및 냉각을 제외하고 384GB와 2,400W를 나타냅니다.
총 VRAM은 자동으로 하나의 공유 메모리 풀로 되지 않습니다. 두 개의 96GB 카드가 본질적으로 하나의 192GB 카드처럼 작동하지는 않습니다. 소프트웨어는 데이터 병렬성, 모델 병렬성 또는 개별 렌더 작업을 사용해야 이점을 얻을 수 있습니다. 117개의 샷의 경우, 여러 노드에 독립적인 작업을 분배하는 것이 하나의 극단적인 워크스테이션을 구축하는 것보다 더 유연한 경우가 많습니다.
샷 단위 품질 및 권리 체크리스트
- 묘사된 모든 캐릭터는 명확하게 성인으로 정의되고 제시됩니다.
- 얼굴, 목소리, 동작 참조 및 훈련 데이터는 문서화된 허가와 출처를 가지고 있습니다.
- 비동의 친밀한 딥페이크 콘텐츠에는 실제 인물이 등장하지 않습니다.
- 정체성, 얼굴, 그리고 신체 구조가 승인된 캐릭터 디자인과 일치합니다.
- 융합된 사지나 교차, 설명되지 않은 해부학적 구조, 또는 물리적으로 일관되지 않은 움직임은 없습니다.
- 옷장, 세트 기하학, 조명 및 화면 방향이 인접한 장면에서도 계속 이어진다.
- 깜박임, 질감 실패, 잘못된 글자 및 파괴적인 보간 프레임이 제거됩니다.
- 대사, 얼굴 연기, 그리고 액션 사운드가 동기화되어 있습니다.
- 프레임 속도, 해상도, 색상 및 음량이 마스터 사양을 충족합니다.
- 출력물은 생산 및 유통 위치 모두에서 법과 플랫폼 규칙을 따릅니다.
자주 묻는 질문
왜 Wan 2.2가 이 성인 AI 단편 영화에 더 적합한가요?
모든 영화에 자동으로 더 좋지는 않습니다. 황구오(Huangguo)는 다운로드 가능한 가중치, 로컬 추론, 외부 학습 도구, 그리고 자체 관리 큐가 필요했습니다. 정책을 준수하는 기존 콘텐츠의 경우, Seedance의 호스팅 멀티모달 워크플로가 더 간단할 수 있습니다.
왜 Seedance를 사용하지 않나요?
Seedance는 호스팅된 생성 서비스로 공개 제공되며, Volcano Engine은 포르노 위험을 포함한 안전 점검 문서를 제공합니다. 또한 그 공개 인터페이스는 최종 사용자에게 기본 모델 학습 스택을 노출하지 않습니다. 이로 인해 일반 영화 제작에서의 장점을 훼손하지 않으면서도 특정 성인 콘텐츠 파이프라인과는 호환되지 않습니다.
8분짜리 AI 영화를 한 번에 생성할 수 있을까?
샷 기반 워크플로우는 현재 더 쉽게 제어하고 수정할 수 있습니다. 황궈는 117개의 독립적으로 검토된 샷을 사용한 후 편집과 사운드를 활용해 연속성을 구축했습니다.
스테이블 디퓨전이나 플럭스가 아직 중요할까?
네. 이미지 모델은 캐릭터 회전도, 세트 참조, 키프레임에 여전히 유용합니다. 비디오 모델과 후반 작업은 움직임, 대화, 시간적 연속성을 처리합니다.
캐릭터와 콘텐츠 LoRA를 합쳐야 할까요?
보통 그렇지 않습니다. 정체성을 움직임이나 콘텐츠 능력과 분리하면 교체, 재훈련, 디버깅이 더 쉬워집니다. 최종 설계는 여전히 데이터셋 크기와 훈련 방법에 따라 달라집니다.
개인용 컴퓨터가 이것을 할 수 있나요?
24GB GPU에서는 TI2V-5B로 시작할 수 있습니다. 그러나 '클립을 렌더링할 수 있음'과 '일정에 맞춰 117개의 승인된 샷을 제공할 수 있음'은 다른 기준입니다. 스토리지, 재시도, 큐 관리, 그리고 인간 검토도 동일하게 중요해집니다.
진짜 장벽은 사설 생산 라인이다
황궈(Huangguo) 방법은 다음과 같이 요약할 수 있습니다: 이야기를 실행 가능한 샷으로 구성합니다; 캐릭터 어댑터로 정체성을 고정합니다; 세트 템플릿으로 공간을 유지합니다; 키프레임을 승인합니다; Wan 2.2와 타겟된 변형으로 짧은 클립을 애니메이션합니다; 라이선스가 있는 참조를 사용하여 어려운 동작을 안내합니다; 대화를 S2V 또는 립싱크를 통해 처리합니다; 그런 다음 30fps 타임라인에서 사운드, 색상, 보간 및 편집을 마무리합니다.
Seedance는 강력한 호스팅 비디오 생성을 나타냅니다. Wan 2.2는 가중치, 추론 코드 및 시스템을 수정할 수 있는 더 많은 공간을 제공합니다. 프라이버시와 반복적인 배치 제작을 강조하는 이 합법적이고 승인된 프로젝트의 경우, 그 차이가 결정적이었습니다. 이 비교는 독자가 자신의 콘텐츠, 예산, 기술 수준 및 준수 의무에 맞는 경로를 판단하도록 돕기 위한 것이며, 하나의 보편적인 '최고 모델'을 제시하기 위한 것이 아닙니다.