先に結論:Huangguoで注目すべきなのは、AIを使ったこと自体ではありません。1つのモデルと1つのプロンプトだけで、8分間の映像を一度に作ろうとしなかった点です。本事例のために提供された制作資料によると、作品は117本の短いカットに分割され、人物の同一性、キーフレーム、動き、会話、仕上げを別々の課題として管理していました。基盤にWan 2.2を選んだのは、Seedanceの映像品質が低いからではありません。ローカルで使える重み、変更可能なパイプライン、継続的なバッチ制作が必要だったためです。
根拠について:上映時間8分、全117カット、カット時間の中央値3.2秒という数字、および本作固有の制作工程は、この記事に提供されたHuangguoの制作資料に基づきます。外部リンクではWan、Seedance、Wan-S2V、NVIDIAが公開している機能を確認できますが、各社が本作の非公開制作ログを検証したわけではありません。
この記事で扱うのは、明確に成人と設定されたキャラクターのみが登場する、合法かつ同意に基づく制作です。年齢が曖昧な表現、未成年、同意のない親密なディープフェイクを容認するものではありません。
SeedanceではなくWan 2.2を選んだ理由
この比較で、Seedanceを性能の低いモデルと位置づけているわけではありません。ByteDanceの公式ページでは、画像、音声、動画を参照できることに加え、演技、照明、カメラワークを制御できる点が紹介されています。ローカル環境を管理せず、整備されたホスティング型の機能を使いたい一般的なプロジェクトにとっては、大きな利点です。
一方、Huangguoには別の条件がありました。100を超えるカットで、サンプリングを繰り返す必要があります。人物の同一性、動き、会話も個別に調整しなければなりません。失敗したカットは、どの工程からでもやり直せることが必須。さらにスタジオ側で、学習素材と生成キューを管理する必要もありました。Wan 2.2はモデルの重みと推論コードを公開しており、T2V、I2V、TI2V、S2Vの各経路を非公開のレンダリングシステムに組み込めます。
| 制作上の要件 | ローカル版Wan 2.2のワークフロー | 公開版Seedanceサービス |
|---|---|---|
| モデルへのアクセス | 重みと推論コードをダウンロード可能 | ホスティング製品またはAPIを通じて完成済みの機能を提供 |
| ローカル推論 | 公式のローカル実行手順あり | 公開モデルページではベースモデルの重みをダウンロードできない |
| LoRAと目的別学習 | コミュニティ製のLoRA/フル学習ツールと連携可能 | 公開インターフェースからベースモデルの学習環境にはアクセスできない |
| バッチ制作 | キュー、キャッシュ、複数ノードのスケジュールを自主管理 | APIの利用上限、料金、サービス規約の制約を受ける |
| 成人向けコンテンツ | ローカルで実行。法律、同意、安全管理の責任は制作者が負う | Volcano Engineは、安全システムがポルノに関するリスクを検出し、ブロックすると説明 |
| 適した用途 | 学習と工程の巻き戻しができる非公開の制作ライン | 規約に適合した作品向けの手軽なマルチモーダル生成 |
これはワークフロー上の選択であり、あらゆるケースに当てはまる画質ランキングではありません。Seedanceは優れたマネージドサービスです。しかし、Huangguoでは重み、データ、スケジュール処理を制作側で管理する必要がありました。また、Volcano Engineの安全な制作に関するページには、明らかに規約違反となる入力と出力を制御し、とりわけポルノに関するリスクを監視すると記載されています。そのため、今回の事例では中心的な生成モデルとして利用できませんでした。
8分の作品を117カットに分けた理由
生成時間が長くなるほど、顔、手、服、背景の形状、人物同士の接触、照明、カメラワークなど、崩れる可能性のある要素が増えます。複雑な動きに小さなミスがあると、数秒の間に悪化しかねません。短いカットにしたからといって、必ずしもテンポの速い映像になるわけではありません。重要なのは、レンダリング結果をカット単位で検証できることです。
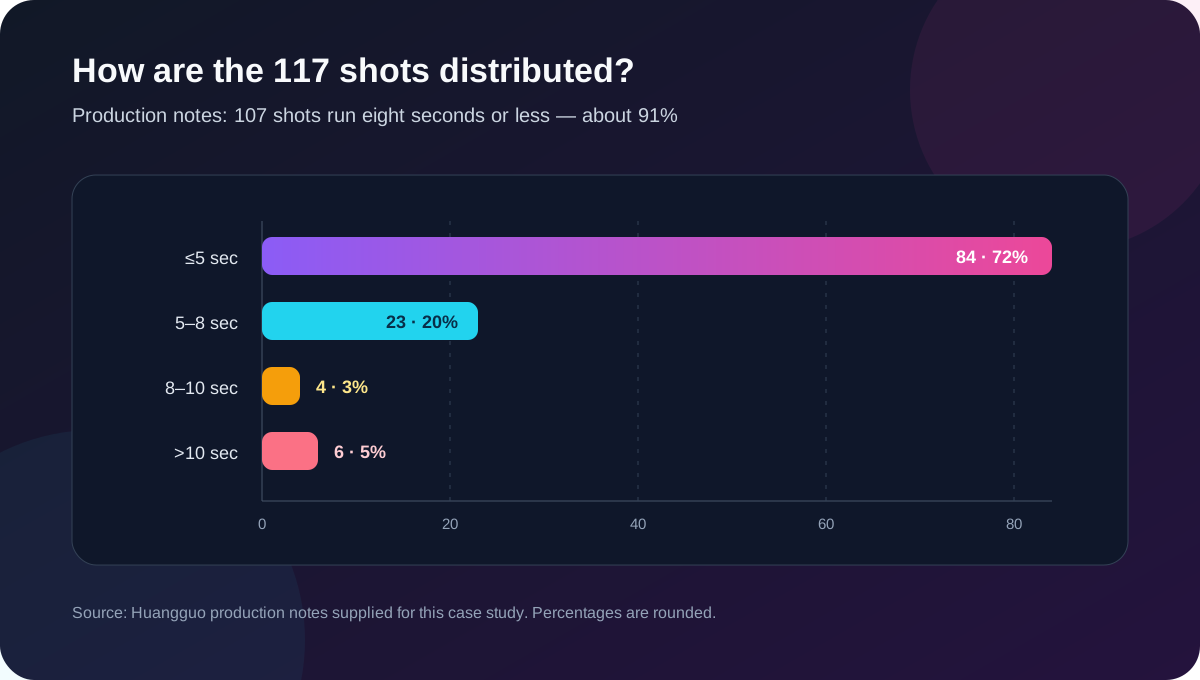
3~8秒のカットなら、視線、振り向き、1つのセリフ、動作の一段階、アングルの変更、細部の挿入といった役割を1つだけ割り当てられます。複雑なシーンも、引きの画、クローズアップ、インサート、リアクションに分けて再構成できます。連続した演技を一度の生成に求めず、編集によって一続きに見せる方法です。
制作ラインの起点は、実行可能なカット設計
1. 脚本を制作データベースに変換する
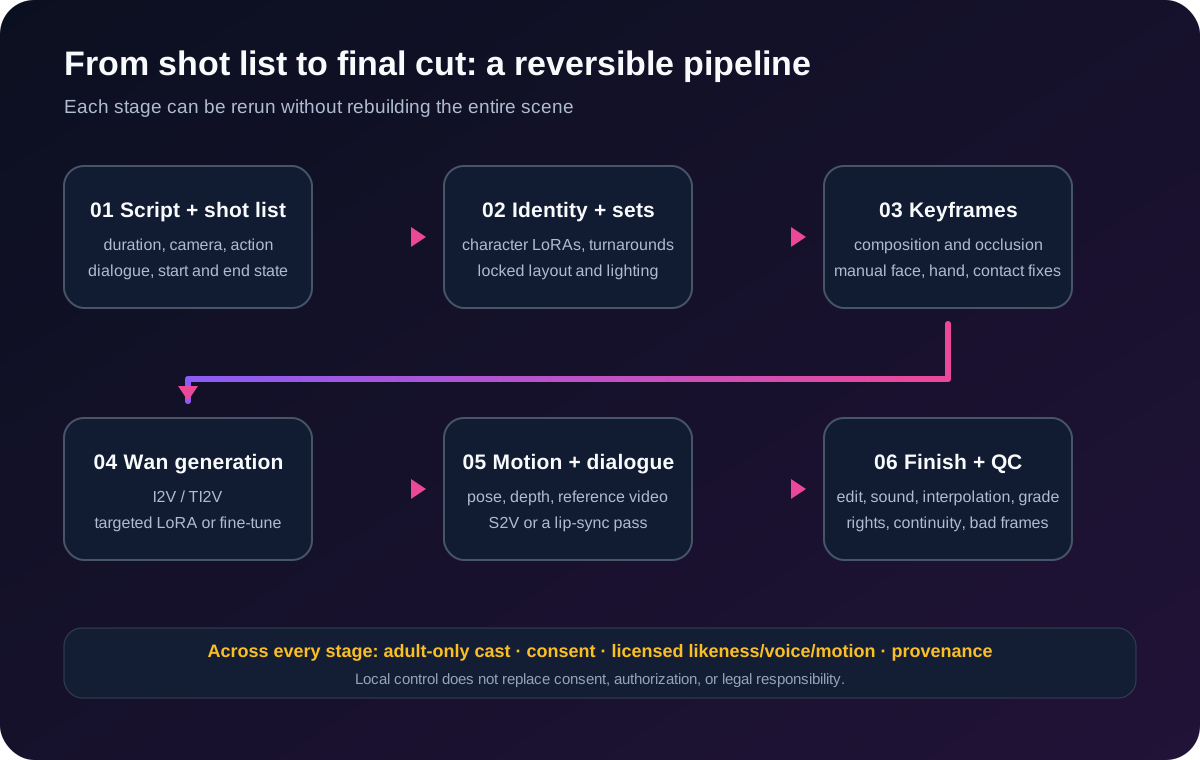
LLMは、筋書き、人物関係、セリフ、シーン順の整理に役立ちます。ただし、LLMが書いた文章をそのままレンダリング指示には使えません。各カットには、ID、セット、出演者、フレーミング、カメラ位置、動作、感情、セリフ、長さ、開始時の状態、終了時の状態、使用するモデル経路、必要なモーション参照や音声参照を設定します。
「2人のキャラクターが部屋で複雑なやり取りを完了する」では曖昧すぎます。入室、接近、反応、位置の変更、細部、終了時の状態に分割しなければなりません。こうすることで、構図、人物の同一性、動きが同じ問題に混ざらず、失敗の原因を診断できます。
2. ドラマ、会話、難しい動きを別々に処理する
制作資料では、各カットを通常の物語描写、会話、成人向けコンテンツ、複雑な動き、環境/場面転換、仕上げ/VFXに分類しています。カテゴリごとに、モデル、アダプター、サンプリング設定、参照素材、合格基準を用意。一律のプリセットは効率的に見えますが、再生成や修正が重なると、そこで得た時間は失われます。
3. キャラクターLoRAには「誰なのか」だけを学習させる
主要キャラクターには、整理された同一性確認用の素材一式が必要です。正面、横顔、斜め向き、表情、照明の変化、上半身、全身、繰り返し登場する衣装の状態などをそろえます。年齢、顔立ち、メイク、体形は、データ全体で一貫していなければなりません。ばらつきがあると、アダプターは曖昧な平均像を学習してしまいます。
人物の同一性と特殊な動きは、別々に学習します。キャラクター用アダプターが、画面内にいる人物を定めます。コンテンツ用またはモーション用アダプターは、必要な演技を指定。分離しておけば、モーション関連をすべて再学習せずにキャラクターだけを差し替えたり、演者の顔を変えずに動きだけを改善したりできます。
技術上、区別しておくべき点があります。Wanの公式リリースが提供するのは、重みと推論コードです。LoRAの学習には通常、DiffSynth-Studioなどのツールを使います。公式リポジトリでは、LoRAとフル学習に対応するコミュニティ連携ツールとして掲載されています。ホスティング型のWan製品に組み込まれたボタンではありません。
4. 繰り返し登場するセットをレンダリング前に固定する
寝室、リビング、ホテル、廊下にも、それぞれ参照素材一式が必要です。ドアや窓の位置、家具の向き、キーライト、色温度、壁の材質、使用可能なカメラ位置を固定します。ベッド、ソファ、壁に触れる演技が多いほど、空間のずれは目立ちます。セット用テンプレートは美術上の参照資料であると同時に、後工程で姿勢や深度を制御するための座標系にもなります。
動かす前に、正しい静止画を作る
通常の物語カットは、承認済みのキーフレームから始めます。静止画の段階で、人物の同一性、表情、衣装、構図、照明、セット、開始時のポーズを確定。より複雑なカットでは、動画生成に入る前に、登場人物の人数、相対的な位置、体の向き、重なり、周囲との接触、カメラアングル、フレーム境界も解決します。
すべてのキーフレームを人の目で確認する必要があります。顔、目、手、手足のつながり、体の比率、衣服の縁、家具との接触、反射、背景内の文字、余計な物体などです。数十枚の動画フレームを直すより、元になる1枚の画像で修正したほうが手間も費用も抑えられます。
特殊なカットを制御する3つのレイヤー
レイヤー1:キーフレームで人物、ポーズ、カメラを固定
用途に合った画像モデルとアダプターを使い、承認用の開始フレームを作ります。このレイヤーで決めるのは、誰が、どこにいて、どのような構図で映るかです。被写体同士の関係を動画モデルが勝手に作り変える余地を減らします。
レイヤー2:Wan 2.2 I2V/TI2Vで時間方向を処理
承認済みのフレームを、そのカットに必要な専用アダプターやファインチューニングとともに、Wan 2.2のI2VまたはTI2V経路へ入力します。このレイヤーが担うのは、動きの連続性、人物の維持、質感の持続、カメラワーク、タイミングです。Wanの公式資料によると、TI2V-5Bは720p・24fpsのtext-to-videoとimage-to-videoの両方に対応し、RTX 4090のような一般消費者向けGPUでも動作します。
レイヤー3:許諾済みの参照素材で動き方を指定
難しい動きには、使用許諾を得た参照動画、骨格ポーズのシーケンス、深度情報を追加できます。これらの入力で、軌道、速度、重心移動、向き、距離、開始時と終了時の状態を制約します。人物は同一性アダプター、動きは参照素材、空間はセット用テンプレートが担当。役割を分けることで、人物の入れ替わり、身体の交差、不安定な接触を減らせます。
通常カット、会話、24fpsから30fpsへの仕上げ
通常カットでは、派手さより編集のしやすさを優先
複数の候補を生成し、人物の同一性、絵コンテとの一致、視線、衣装とセットの連続性、問題のあるフレームをきれいに切り落とせるかを確認します。途中で映像が崩れる大胆なカメラワークより、最初から最後まで破綻しない控えめなカットのほうが有用です。
会話:Wan-S2Vまたは別工程のリップシンク
Wan-S2Vの公式プロジェクトでは、1枚の画像と音声から、自然な表情、身体動作、映画的なカメラワークを伴う同期動画を生成するモデルと説明されています。ただし、会話カットに必要なのは口の形だけではありません。話し始める前の呼吸、間、目の動き、姿勢、セリフ後の反応が、演技の説得力につながります。S2Vが適さない場合は、先に映像を生成し、ポストプロダクションでリップシンクを適用できます。
24fpsから30fpsへ:フレーム複製は補間ではない
制作資料によると、Wanの素材クリップは24fpsで生成し、30fpsのマスターに合わせています。単純な複製による変換では、1秒あたり6枚の出力フレームが追加されます。言い換えると、出力フレーム5枚につき1枚が重複フレームです。一方、オプティカルフローやAIによる補間では、フレーム間を埋める合成画像を作るため、発生するアーティファクトの傾向が異なります。
どちらの方法でも、カット単位の確認が必要です。手、髪、重なり合う人物、高速な動きでは、元のフレームが使える状態でも、その間に新たな構造上の破綻が生じることがあります。仕上げ工程には、アップスケール、ちらつき除去、ノイズ除去、色合わせ、露出補正、部分的な描き直し、不良フレームの削除、軽いスタビライズ処理も含まれました。
117本のクリップを1本の映画にまとめる音響と編集
動画生成の完了は、素材がそろった段階にすぎません。TTSによるセリフ、環境音、動作音、音楽、トランジション、ミキシング、ノイズ除去、ラウドネスの正規化によって、音の連続性を作ります。字幕、メッセージ画面、システムUI、タイトル、抑制の利いたVFXも、物語を伝えるための構成要素です。
最終編集では、失敗したフレームをすべて取り除きながら、画面内の移動方向、視線、衣装、セットの照明、カット接続時の動作、リップシンク、音のタイミングを保たなければなりません。AIが作ったのは117個の別々の素材。それらを8分間の短編としてまとめたのは編集です。
このワークフローに必要なハードウェア
VRAM 24GB:検証には使えるが、大規模な納品には十分とは限らない
Wan公式のTI2V-5B用コマンドは、モデルのオフロード、dtype変換、T5のCPU配置を使うことで、24GB以上のVRAMを搭載した環境で実行できます。キャラクターのテスト、プロンプト開発、キーフレーム、限られた数のクリップには有用です。ただし、117カットの納品では処理量が問題になります。承認される各カットの前に、複数の不採用テイクが発生する可能性があるためです。
デュアルGPUまたは複数ノード:重要なのはキューの並列処理
NVIDIAによると、RTX PRO 6000 Blackwell Workstation Editionは96GBのGDDR7 ECCメモリを搭載し、最大ボード電力は600Wです。したがって2枚ならVRAMの合計は192GB、最大ボード電力は1,200W。4枚なら384GB、2,400Wとなります。いずれもCPU、ストレージ、メモリ、冷却設備の分は含みません。
VRAMの合計容量が、自動的に1つの共有メモリ領域になるわけではありません。96GBのカードを2枚搭載しても、それだけで1枚の192GBカードのように動作するわけではありません。活用するには、ソフトウェア側でデータ並列、モデル並列、または個別のレンダリングジョブを使う必要があります。117カットを扱うなら、極端に高性能なワークステーションを1台組むより、複数ノードへ独立したジョブを分配するほうが柔軟な場合もあります。
カット単位の品質・権利チェックリスト
- 描写されるすべてのキャラクターが、明確に成人と定義され、成人として表現されている。
- 顔、声、モーション参照、学習データについて、使用許諾と出所が文書で確認できる。
- 実在人物が、同意のない親密なディープフェイクに使われていない。
- 人物の同一性、顔、身体構造が、承認済みのキャラクターデザインと一致している。
- 手足の融合、身体の交差、説明のつかない人体構造、物理的に不自然な動きがない。
- 隣接するカット間で、衣装、セットの形状、照明、画面内の移動方向が連続している。
- ちらつき、質感の破綻、偽の文字、映像を損なう補間フレームが除去されている。
- セリフ、顔の演技、動作音が同期している。
- フレームレート、解像度、色、ラウドネスがマスター仕様を満たしている。
- 制作地と配信地の両方で、出力内容が法律とプラットフォーム規約に従っている。
よくある質問
この成人向けAI短編にWan 2.2が適していたのはなぜですか?
すべての映画で自動的に最適となるわけではありません。Huangguoでは、ダウンロード可能な重み、ローカル推論、外部の学習ツール、自主管理できるキューが必要でした。規約に適合する一般的なコンテンツなら、Seedanceのホスティング型マルチモーダルワークフローのほうが簡単な場合があります。
Seedanceを使わなかったのはなぜですか?
Seedanceはホスティング型の生成サービスとして一般公開されており、Volcano Engineはポルノに関するリスクを含む安全確認について説明しています。また、公開インターフェースから、エンドユーザーがベースモデルの学習環境へアクセスすることはできません。そのため、一般的な映像制作における長所を損なうものではないものの、今回の成人向けコンテンツ用パイプラインには適合しません。
8分間のAI映画を一度に生成できますか?
現状では、カット単位のワークフローのほうが制御と修正をしやすい方法です。Huangguoでは、個別に確認した117カットを使い、編集と音響によって連続性を作りました。
Stable DiffusionやFluxも引き続き必要ですか?
はい。画像モデルは、キャラクターの三面図・設定画、セットの参照画像、キーフレームの制作に今も役立ちます。動き、会話、時間方向の連続性は、動画モデルとポストプロダクションで処理します。
キャラクターLoRAとコンテンツLoRAは統合すべきですか?
通常は分けます。人物の同一性を、動きやコンテンツに関する能力から切り離すと、差し替え、再学習、問題の切り分けがしやすくなります。ただし、最終的な設計はデータセットの規模と学習方法によって異なります。
個人用パソコンでも制作できますか?
24GBのGPUがあれば、TI2V-5Bから始められます。ただし、「クリップをレンダリングできること」と「承認済みの117カットを期限内に納品できること」は、別の水準です。ストレージ、再生成、キュー管理、人による確認も同じくらい重要になります。
本当のハードルは、非公開の制作ラインを整えること
Huangguoの手法は、次のようにまとめられます。物語を実行可能なカットに分解する。キャラクター用アダプターで人物を固定する。セット用テンプレートで空間を保つ。キーフレームを承認する。Wan 2.2と目的別の派生モデルで短いクリップを動かす。難しい動きは許諾済みの参照素材で誘導する。会話にはS2Vまたはリップシンクを使う。そして30fpsのタイムライン上で、音響、色、補間、編集を仕上げるという流れです。
Seedanceは高性能なホスティング型動画生成サービスです。Wan 2.2は重みと推論コードを提供し、システムを変更できる余地が広くなっています。プライバシーと反復的なバッチ制作を重視した、この合法かつ許諾済みのプロジェクトでは、その違いが決め手になりました。この比較の目的は、読者が自身のコンテンツ、予算、技術力、法令・規約上の義務に合う方法を判断できるようにすることです。あらゆる用途に共通する「最高のモデル」を決めるものではありません。