In breve: l'aspetto interessante di Huangguo non è l'impiego dell'AI. È il fatto che i filmmaker non abbiano chiesto a un unico modello di creare un film di otto minuti partendo da un solo prompt. Secondo le note di produzione fornite per questo case study, hanno suddiviso il film in 117 brevi inquadrature e gestito separatamente identità, fotogrammi chiave, movimento, dialoghi e finalizzazione. Wan 2.2 è stato scelto come base perché il progetto richiedeva pesi eseguibili in locale, una pipeline modificabile e una produzione in batch continuativa, non perché Seedance sia carente sul piano della qualità visiva.
Nota sulle fonti: la durata di otto minuti, il totale di 117 inquadrature, la durata mediana di 3,2 secondi e il processo specifico del progetto provengono dal materiale di produzione di Huangguo fornito per questo articolo. I link esterni verificano le funzionalità pubbliche di Wan, Seedance, Wan-S2V e NVIDIA; queste aziende non hanno verificato il registro di produzione privato del film.
Questo articolo tratta esclusivamente una produzione lecita e basata sul consenso, con personaggi chiaramente adulti. Non approva contenuti dall'età ambigua, minori o deepfake intimi non consensuali.
Perché Wan 2.2 invece di Seedance?
In questo confronto Seedance non è il modello più debole. La pagina ufficiale di ByteDance evidenzia l'uso di riferimenti visivi, audio e video, oltre al controllo su recitazione, illuminazione e movimenti di macchina. Per un progetto convenzionale che desidera uno strumento in hosting ben rifinito senza dover mantenere un'infrastruttura locale, può essere un vantaggio importante.
Huangguo aveva esigenze diverse. Più di cento inquadrature richiedevano campionamenti ripetuti. Identità dei personaggi, movimento e dialoghi dovevano poter essere modificati in modo indipendente. In caso di errore, occorreva poter recuperare l'inquadratura da qualunque fase. Lo studio doveva inoltre mantenere il controllo sulle risorse di addestramento e sulla coda di generazione. Wan 2.2 pubblica i pesi del modello e il codice di inferenza, con percorsi T2V, I2V, TI2V e S2V integrabili in un sistema di rendering privato.
| Requisito di produzione | Flusso locale con Wan 2.2 | Servizio pubblico Seedance |
|---|---|---|
| Accesso al modello | Pesi e codice di inferenza scaricabili | Funzionalità pronte all'uso tramite prodotti o API in hosting |
| Inferenza locale | Istruzioni ufficiali per l'esecuzione in locale | La pagina pubblica del modello non offre pesi di base scaricabili |
| LoRA e addestramento mirato | Può collegarsi a strumenti della community per LoRA e addestramento completo | Lo stack di addestramento del modello di base non è accessibile dall'interfaccia pubblica |
| Produzione in batch | Code, cache e pianificazione multinodo gestite in proprio | Soggetta a quote API, prezzi e regole del servizio |
| Contenuti per adulti | Esecuzione locale; il produttore resta responsabile del rispetto di legge, consenso e sicurezza | Volcano Engine dichiara che il suo sistema di sicurezza rileva e blocca il rischio di contenuti pornografici |
| Impiego ideale | Linea di produzione privata, addestrabile e reversibile | Generazione multimodale pratica per lavori conformi alle norme |
È una decisione sul flusso di lavoro, non una classifica universale della qualità delle immagini. Seedance offre un valido servizio gestito. Huangguo aveva bisogno di controllare pesi, dati e logica di pianificazione. Anche la pagina di Volcano Engine dedicata alla creazione sicura afferma che la piattaforma controlla input e output chiaramente non conformi, con particolare attenzione al rischio di contenuti pornografici: questo le impedisce di fungere da generatore principale in questo caso.
Perché suddividere otto minuti in 117 inquadrature?
Più una generazione è lunga, più aumentano gli elementi che possono perdere coerenza: volti, mani, abiti, geometria dello sfondo, contatto tra i personaggi, illuminazione e movimenti di macchina. In un'interazione complessa, un piccolo errore può aggravarsi nel giro di pochi secondi. Le inquadrature brevi non producono automaticamente un ritmo più rapido: rendono verificabile ogni rendering.
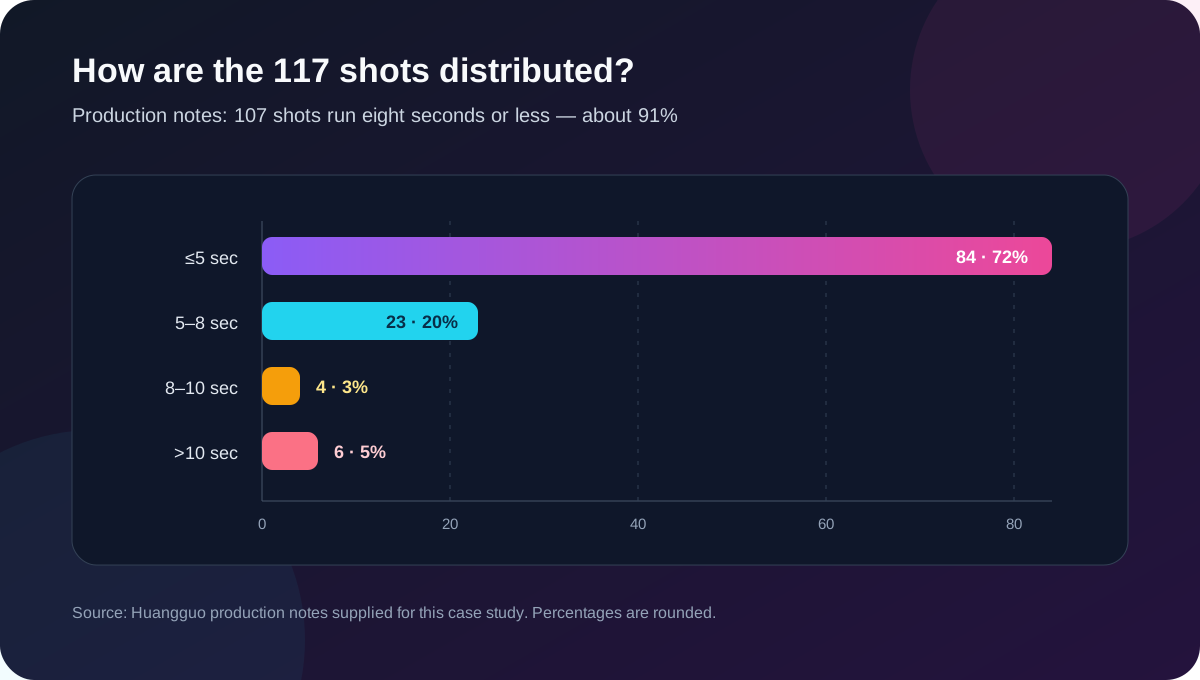
A un'inquadratura di durata compresa tra tre e otto secondi si può assegnare un solo compito: una direzione dello sguardo, una rotazione, una battuta, una fase del movimento, un cambio di angolazione o un inserto di dettaglio. Le scene complesse possono essere ricostruite con campi lunghi, primi piani, inserti e reazioni. La sensazione di una recitazione continua nasce dal montaggio, anziché essere pretesa da una singola generazione.
La linea di produzione parte da inquadrature eseguibili
1. Trasformare la sceneggiatura in un database di produzione
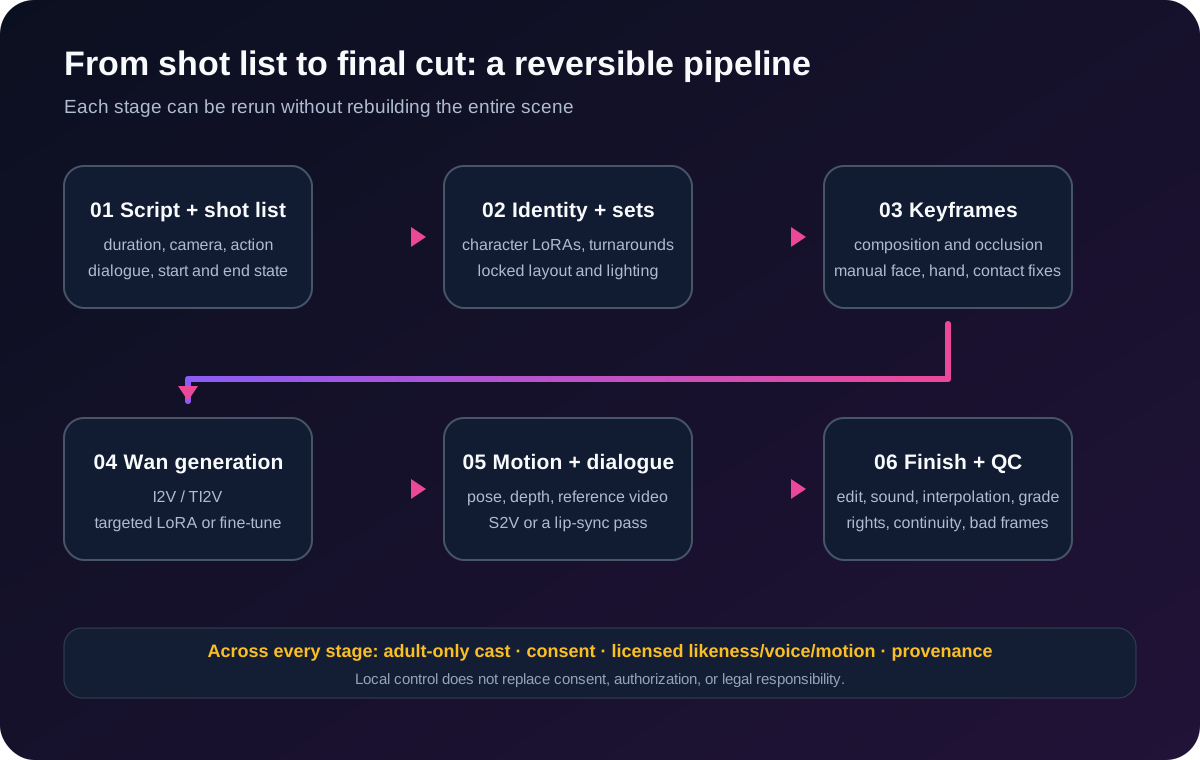
Un LLM può aiutare a organizzare trama, relazioni, dialoghi e ordine delle scene. La sua bozza in prosa non è però un'attività di rendering utilizzabile. Ogni inquadratura richiede un ID, il set, il cast, il tipo di piano, la posizione della macchina da presa, l'azione, l'emozione, il dialogo, la durata, lo stato iniziale e finale, il percorso del modello ed eventuali riferimenti audio o di movimento.
«Due personaggi completano un'interazione complessa in una stanza» è un'indicazione troppo vaga. La scena deve essere suddivisa in ingresso, avvicinamento, reazione, cambio di posizione, dettaglio e stato finale. In questo modo è possibile diagnosticare gli errori: composizione, identità e movimento non confluiscono più nello stesso problema.
2. Gestire separatamente narrazione, dialoghi e movimenti difficili
Le note di produzione classificano le inquadrature come narrazione ordinaria, dialogo, contenuto per adulti, movimento complesso, ambiente/transizione oppure finalizzazione/VFX. A ogni categoria vengono assegnati modelli, adattatori, parametri di campionamento, riferimenti e test di accettazione specifici. Un'unica preimpostazione universale sembra efficiente finché tentativi ripetuti e correzioni non annullano il risparmio.
3. Fare in modo che il LoRA del personaggio risponda soltanto a «chi è?»
I personaggi principali richiedono un pacchetto d'identità pulito: vista frontale, profilo, vista di tre quarti, espressioni, variazioni di luce, figura intera e mezzo busto, oltre agli abiti ricorrenti. Età, forma del viso, trucco e proporzioni devono rimanere coerenti in tutti i dati; in caso contrario, l'adattatore apprende una media indistinta.
Identità e movimenti specializzati vengono addestrati separatamente. L'adattatore del personaggio stabilisce chi è presente nell'inquadratura. Un adattatore per contenuto o movimento descrive la recitazione richiesta. Questa modularità consente allo studio di sostituire un personaggio senza riaddestrare l'intero stack di movimento o di migliorare il movimento senza cambiare il volto dell'interprete.
È importante una distinzione tecnica: la versione ufficiale di Wan fornisce pesi e codice di inferenza. L'addestramento LoRA avviene in genere tramite strumenti come DiffSynth-Studio, che il repository ufficiale elenca come integrazione della community in grado di supportare LoRA e addestramento completo. Non è un pulsante incorporato in un prodotto Wan in hosting.
4. Definire i set ricorrenti prima del rendering
Camere da letto, soggiorni, hotel e corridoi richiedono pacchetti di riferimenti dedicati. Occorre fissare la posizione di porte e finestre, l'orientamento dei mobili, la luce principale, la temperatura colore, il materiale delle pareti e le posizioni utilizzabili per la macchina da presa. Più la recitazione comporta interazioni con letti, divani o pareti, più diventano evidenti le incoerenze spaziali. Un modello del set è sia un riferimento per la direzione artistica sia un sistema di coordinate per il successivo controllo di posa e profondità.
Creare l'immagine fissa corretta prima di chiederle di muoversi
Le normali inquadrature narrative iniziano come fotogrammi chiave approvati. L'immagine fissa definisce identità, espressione, abiti, composizione, luce, set e posa iniziale. Prima che inizi la generazione video, le inquadrature più complesse definiscono inoltre il numero di personaggi, la posizione relativa, l'orientamento del corpo, le occlusioni, il contatto con l'ambiente, l'angolazione della macchina da presa e i limiti del fotogramma.
Ogni fotogramma chiave deve essere controllato manualmente. Volti, occhi, mani, collegamenti tra gli arti, proporzioni, bordi degli abiti, contatto con i mobili, riflessi, testo sullo sfondo e oggetti estranei costano meno da correggere una volta nell'immagine sorgente che in decine di fotogrammi video.
I tre livelli di controllo per le inquadrature specializzate
Livello 1: il fotogramma chiave fissa identità, posa e macchina da presa
Un modello di immagini appositamente predisposto e i relativi adattatori creano il fotogramma iniziale approvato. Questo livello stabilisce chi è presente, dove si trova e come viene inquadrata la scena. Lascia meno libertà al modello video di riprogettare il rapporto tra i soggetti.
Livello 2: Wan 2.2 I2V/TI2V gestisce il tempo
Il fotogramma approvato entra in un percorso I2V o TI2V di Wan 2.2, insieme agli adattatori mirati o al fine-tuning richiesto dall'inquadratura. Questo livello gestisce continuità del movimento, conservazione dell'identità, persistenza delle texture, movimenti di macchina e tempi. La documentazione ufficiale di Wan afferma che TI2V-5B supporta sia la generazione da testo a video sia quella da immagine a video a 720p e 24fps e può essere eseguito su una GPU consumer come RTX 4090.
Livello 3: i riferimenti concessi in licenza descrivono come si muove l'azione
Per i movimenti difficili è possibile aggiungere video di riferimento autorizzati, sequenze di pose scheletriche o informazioni di profondità. Questi input vincolano traiettoria, velocità, spostamento del peso, orientamento, distanza e stato iniziale/finale. Gli adattatori d'identità controllano l'interprete; i riferimenti controllano il movimento; il modello del set delimita lo spazio. Separare queste responsabilità riduce lo scambio tra personaggi, le intersezioni corporee e i contatti instabili.
Inquadrature ordinarie, dialoghi e finalizzazione da 24 a 30fps
Nelle inquadrature ordinarie, la possibilità di montare conta più della spettacolarità
Genera diverse varianti, quindi controlla identità, rispetto dello storyboard, direzione degli sguardi, continuità di abiti e set e possibilità di eliminare nettamente i fotogrammi difettosi. Un'inquadratura misurata, valida dal primo all'ultimo fotogramma, è più utile di un ambizioso movimento di macchina che si deforma a metà.
Dialoghi: Wan-S2V o una fase separata di sincronizzazione labiale
Il progetto ufficiale Wan-S2V descrive un modello che trasforma un'immagine e un audio in un video sincronizzato, con espressioni naturali, movimenti del corpo e comportamento cinematografico della macchina da presa. Un'inquadratura di dialogo efficace richiede comunque più delle sole forme della bocca. Il respiro prima di parlare, le pause, il movimento degli occhi, la postura e la reazione dopo la battuta rendono credibile la recitazione. Quando S2V non è il percorso giusto, il team può generare prima la parte visiva e applicare la sincronizzazione labiale in post-produzione.
Da 24fps a 30fps: duplicare fotogrammi non significa interpolare
Le note di produzione affermano che le clip sorgente di Wan sono state generate a 24fps e uniformate a un master a 30fps. Una conversione di base mediante duplicazione aggiunge sei fotogrammi in uscita al secondo, vale a dire un fotogramma ripetuto ogni cinque fotogrammi in uscita. L'interpolazione mediante flusso ottico o AI crea invece fotogrammi intermedi sintetici e presenta artefatti di tipo diverso.
Entrambi i metodi richiedono un controllo inquadratura per inquadratura. Mani, capelli, figure sovrapposte e movimenti rapidi possono produrre nuovi errori strutturali tra fotogrammi sorgente altrimenti utilizzabili. La finalizzazione ha inoltre incluso aumento della risoluzione, rimozione dello sfarfallio, riduzione del rumore, uniformazione dei colori, correzione dell'esposizione, ridisegno locale, eliminazione dei fotogrammi difettosi e una lieve stabilizzazione.
Audio e montaggio trasformano 117 clip in un unico film
Completare la generazione video significa soltanto avere a disposizione il materiale grezzo. Dialoghi TTS, suoni ambientali e d'azione, musica, transizioni, missaggio, riduzione del rumore e normalizzazione del volume creano continuità sonora. Sottotitoli, grafiche dei messaggi, interfacce di sistema, titoli e VFX discreti completano la veste narrativa.
Il montaggio finale deve preservare direzione sullo schermo, sguardi, abiti, illuminazione del set, continuità dell'azione al taglio, sincronizzazione labiale e tempi sonori, eliminando ogni fotogramma difettoso. L'AI ha prodotto 117 elementi separati. Il montaggio li ha trasformati in un cortometraggio di otto minuti.
Quale hardware richiede questo flusso di lavoro?
24GB di VRAM: sufficienti per la convalida, non necessariamente per una produzione su larga scala
Il comando ufficiale TI2V-5B di Wan può essere eseguito con almeno 24GB di VRAM ricorrendo all'offloading del modello, alla conversione del tipo di dati e all'esecuzione di T5 sulla CPU. È utile per test sui personaggi, sviluppo dei prompt, fotogrammi chiave e un numero limitato di clip. La consegna di 117 inquadrature è però un problema di capacità produttiva: ogni inquadratura approvata può arrivare dopo diversi tentativi scartati.
Due GPU o più nodi: contano soprattutto le code parallele
NVIDIA indica 96GB di memoria GDDR7 ECC e una potenza massima della scheda di 600W per RTX PRO 6000 Blackwell Workstation Edition. Due schede rappresentano quindi un totale di 192GB di VRAM e 1.200W di potenza massima; quattro arrivano a 384GB e 2.400W, prima di considerare CPU, archiviazione, memoria e raffreddamento.
La VRAM complessiva non diventa automaticamente un unico pool di memoria condivisa. Due schede da 96GB non si comportano per loro natura come una sola scheda da 192GB. Per sfruttarle, il software deve ricorrere al parallelismo dei dati, al parallelismo del modello o a processi di rendering separati. Per 117 inquadrature, distribuire processi indipendenti su più nodi è spesso più flessibile che costruire un'unica workstation estrema.
Checklist di qualità e diritti per ogni inquadratura
- Ogni personaggio raffigurato è esplicitamente definito e presentato come adulto.
- Volti, voci, riferimenti di movimento e dati di addestramento dispongono di autorizzazione e provenienza documentate.
- Nessuna persona reale compare in contenuti intimi deepfake non consensuali.
- Identità, volto e struttura corporea corrispondono al design approvato del personaggio.
- Non sono presenti arti fusi, intersezioni, anatomie inspiegabili o movimenti fisicamente incoerenti.
- Abiti, geometria del set, illuminazione e direzione sullo schermo mantengono la continuità tra inquadrature adiacenti.
- Sfarfallio, difetti delle texture, testo errato e fotogrammi interpolati dannosi sono stati rimossi.
- Dialoghi, recitazione facciale e suoni d'azione sono sincronizzati.
- Frequenza dei fotogrammi, risoluzione, colore e volume rispettano le specifiche del master.
- Il risultato rispetta le leggi e le regole delle piattaforme sia nei luoghi di produzione sia in quelli di distribuzione.
Domande frequenti
Perché Wan 2.2 è più adatto a questo cortometraggio AI per adulti?
Non è automaticamente migliore per ogni film. Huangguo richiedeva pesi scaricabili, inferenza locale, strumenti di addestramento esterni e code gestite in proprio. Per contenuti convenzionali conformi alle norme, il flusso multimodale in hosting di Seedance può essere più semplice.
Perché non usare Seedance?
Seedance viene offerto pubblicamente come servizio di generazione in hosting e Volcano Engine documenta controlli di sicurezza che includono il rischio di contenuti pornografici. Inoltre, la sua interfaccia pubblica non rende accessibile agli utenti finali lo stack di addestramento del modello di base. Questo lo rende incompatibile con questa specifica pipeline per contenuti per adulti, senza sminuirne i punti di forza per la produzione cinematografica ordinaria.
È possibile generare un film AI di otto minuti in un solo passaggio?
Attualmente, un flusso basato su singole inquadrature è più facile da controllare e correggere. Huangguo ha utilizzato 117 inquadrature esaminate in modo indipendente, affidandosi poi a montaggio e audio per creare continuità.
Stable Diffusion o Flux sono ancora utili?
Sì. I modelli di immagini restano utili per viste del personaggio da diverse angolazioni, riferimenti dei set e fotogrammi chiave. I modelli video e la post-produzione gestiscono movimento, dialoghi e continuità temporale.
I LoRA del personaggio e del contenuto vanno uniti?
In genere no. Separare l'identità dalle capacità relative a movimento o contenuto semplifica sostituzione, riaddestramento e risoluzione dei problemi. Il progetto finale dipende comunque dalle dimensioni del set di dati e dal metodo di addestramento.
Si può fare con un personal computer?
Si può iniziare con TI2V-5B su una GPU da 24GB. «Riuscire a eseguire il rendering di una clip» e «consegnare puntualmente 117 inquadrature approvate» sono però traguardi diversi. Spazio di archiviazione, nuovi tentativi, gestione delle code e controllo umano diventano altrettanto importanti.
Il vero ostacolo è una linea di produzione privata
Il metodo Huangguo si può riassumere così: strutturare la storia in inquadrature eseguibili; fissare l'identità con gli adattatori dei personaggi; mantenere la coerenza dello spazio con modelli dei set; approvare i fotogrammi chiave; animare brevi clip con Wan 2.2 e varianti mirate; guidare i movimenti difficili con riferimenti concessi in licenza; gestire i dialoghi tramite S2V o sincronizzazione labiale; infine completare audio, colore, interpolazione e montaggio su una timeline a 30fps.
Seedance rappresenta una potente soluzione di generazione video in hosting. Wan 2.2 offre pesi, codice di inferenza e maggiore libertà di modifica del sistema. Per questo progetto lecito e autorizzato, incentrato su privacy e produzione ripetuta in batch, la differenza è stata decisiva. Il confronto intende aiutare chi legge a valutare il percorso più adatto ai propri contenuti, al budget, alle competenze tecniche e agli obblighi di conformità, non a stabilire un unico «modello migliore» in assoluto.
Fonti ufficiali
- Repository ufficiale di Wan 2.2: pesi, inferenza, esempi hardware e integrazioni di addestramento della community
- Scheda ufficiale del modello Wan 2.2 TI2V-5B
- Pagina ufficiale del progetto Wan-S2V
- Panoramica ufficiale di ByteDance Seedance 2.0
- Sistema di Volcano Engine per la creazione sicura con Seedance 2.0
- Specifiche ufficiali di NVIDIA RTX PRO 6000 Blackwell