התשובה הקצרה: החלק המעניין של Huangguo זה לא ש-AI היה מעורב. זה שיוצרי הסרט לא ביקשו מדוגמנית אחת ליצור סרט בן שמונה דקות מתוך הנחיה אחת. לפי הערות ההפקה שסופקו למקרה בוחן זה, הם חילקו את הסרט ל-117 צילומים קצרים וזהות מבוקרת, פריימים מפתח, תנועה, דיאלוג וגימור כבעיות נפרדות. Wan 2.2 היה הבסיס מכיוון שהפרויקט נזקק למשקלים מקומיים, צינור שניתן לשינוי וייצור אצווה מתמשך - לא בגלל ש-Seedance חסרה איכות ויזואלית.
לגבי הראיות: זמן הריצה של שמונה דקות, ספירת 117 יריות, אורך זריקה חציוני של 3.2 שניות והתהליך הספציפי לפרויקט מגיעים מחומר ייצור Huangguo שסופק עבור מאמר זה. קישורים חיצוניים מאמתים את יכולות Wan, Seedance, Wan-S2V ו-NVIDIA; חברות אלו לא אימתו את יומן ההפקה הפרטי של הסרט.
מאמר זה מכסה הפקה חוקית מבוססת הסכמה הכוללת דמויות בוגרות בבירור בלבד. הוא אינו תומך בתוכן מעורפל גיל, קטינים או זיופים עמוקים אינטימיים ללא הסכמה.
למה Wan 2.2 במקום Seedance?
Seedance הוא לא הדגם החלש בהשוואה זו. העמוד הרשמי של ByteDance מדגיש הפניות לתמונה, אודיו ווידאו בתוספת שליטה על ביצועים, תאורה ותנועת המצלמה. עבור פרויקט קונבנציונלי שרוצה יכולת אירוח מלוטשת ללא תחזוקה של תשתית מקומית, זה יכול להיות יתרון גדול.
ל-Huangguo הייתה ערכת אילוצים אחרת. יותר ממאה זריקות הצריכו דגימה חוזרת. זהות אופי, תנועה ודיאלוג היו צריכים להיות מתאימים באופן עצמאי. זריקה כושלת הייתה חייבת להיות ניתנת לשחזור מכל שלב. הסטודיו גם היה צריך להחזיק בנכסי ההכשרה שלו ובתור הייצור שלו. Wan 2.2 publishes model weights and inference code, with T2V, I2V, TI2V, and S2V paths that can be integrated into a private render system.
| דרישת ייצור | זרימת עבודה מקומית של Wan 2.2 | שירות Seedance ציבורי |
|---|---|---|
| גישה לדגם | משקלים וקוד מסקנות להורדה | יכולת מוגמרת באמצעות מוצרים מתארחים או APIs |
| מסקנות מקומיות | הוראות ריצה מקומיות רשמיות | דף הדגם הציבורי אינו מציע משקלי בסיס להורדה |
| LoRA והדרכה ממוקדת | יכול להתחבר לקהילה LoRA/כלי אימון מלאים | ערימת אימון מודל בסיס אינה נחשפת דרך הממשק הציבורי |
| ייצור אצווה | תורים בניהול עצמי, מטמונים ותזמון ריבוי צמתים | בכפוף למכסות API, לתמחור ולכללי השירות |
| תוכן למבוגרים | ביצוע מקומי; המפיק נשאר אחראי לחוק, להסכמה ולבטיחות | Volcano Engine מצהיר כי מערכת הבטיחות שלו מזהה וחוסמת סיכונים פורנוגרפיים |
| ההתאמה הטובה ביותר | פס ייצור פרטי הניתן לאימון, הפיך | דור רב-מודאלי נוח לעבודה תואמת מדיניות |
זוהי החלטת זרימת עבודה, לא דירוג אוניברסלי של איכות תמונה. Seedance מציע שירות מנוהל חזק. Huangguo נזקק לבעלות על משקלים, נתונים והיגיון תזמון. עמוד יצירת הבטיחות של Volcano Engine עצמו גם אומר שהפלטפורמה שלו שולטת בקלט ופלט בבירור שאינם תואמים, תוך תשומת לב ספציפית לסיכון פורנוגרפי, מה שפוסל אותו כמחולל המרכזי למקרה זה.
למה לחלק שמונה דקות ל-117 זריקות?
דורות ארוכים יותר מכפילים את מספר הדברים שיכולים להיסחף: פנים, ידיים, בגדים, גיאומטריית רקע, מגע בין דמויות, תאורה ותנועת המצלמה. שגיאה קטנה באינטראקציה מורכבת עשויה להתערב בשניות. צילומים קצרים אינם בקצב מהיר יותר באופן אוטומטי; הם הופכים כל עיבוד לניתן לבדיקה.
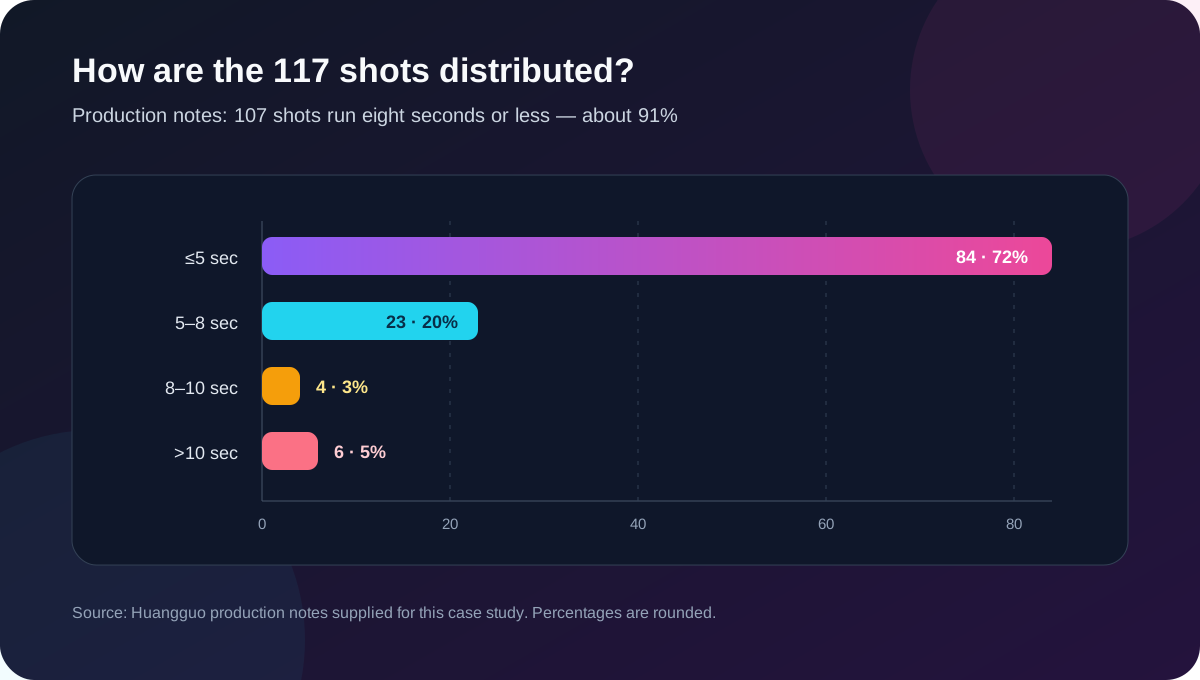
צילום של שלוש עד שמונה שניות ניתן להקצות עבודה אחת: קו עין, סיבוב, משפט אחד, שלב תנועה אחד, שינוי זווית או הוספת פרטים. ניתן לבנות מחדש סצנות מורכבות מצילומים רחבים, תקריב, תוספות ותגובות. תחושת הביצוע המתמשך נוצרת בעריכה במקום להידרש מדור אחד.
פס הייצור מתחיל בצילומי הפעלה
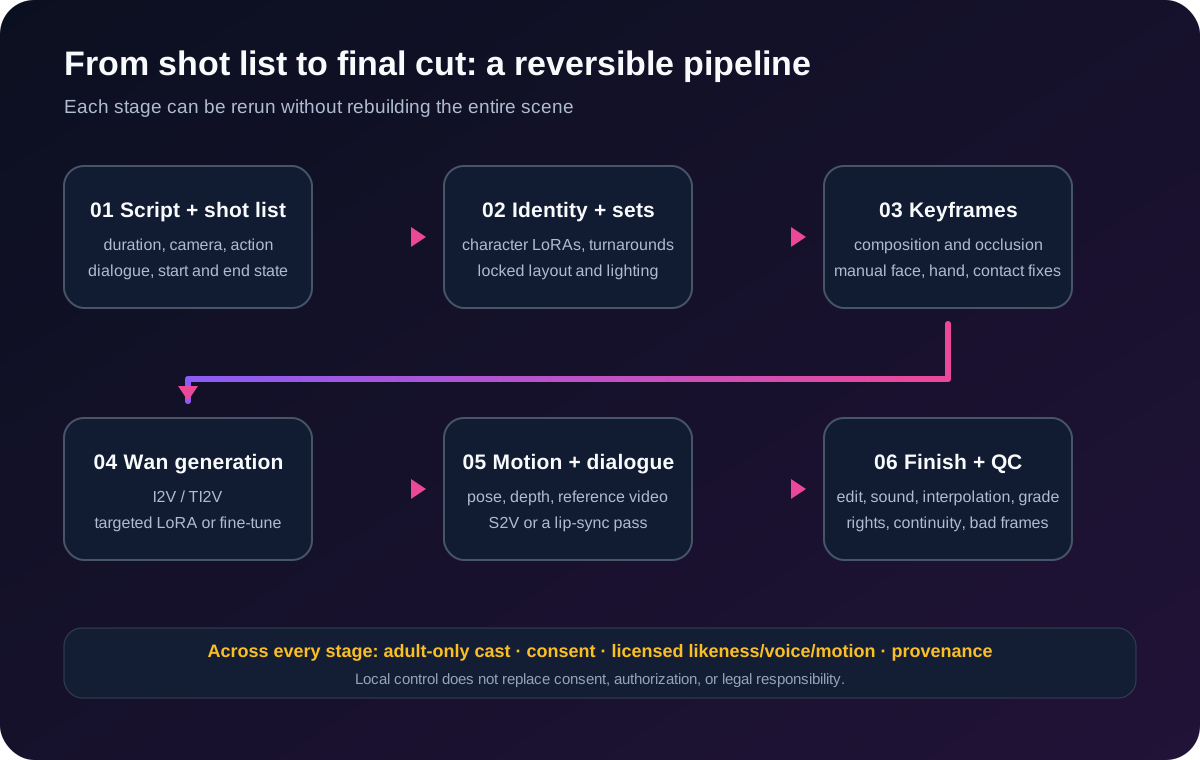
1. הפוך את התסריט למסד נתונים ייצור
LLM יכול לעזור לארגן עלילה, מערכות יחסים, דיאלוג וסדר סצנה. טיוטת הפרוזה שלה אינה משימת רינדור שמישה. כל צילום צריך מזהה, סט, קאסט, מסגור, מיקום מצלמה, פעולה, רגש, דיאלוג, משך, מצב פתיחה, מצב סיום, מסלול דגם, וכל תנועה או התייחסות אודיו נדרשת.
"שתי דמויות משלימות אינטראקציה מורכבת בחדר" מעורפל מדי. יש לחלק את הסצנה לכניסה, גישה, תגובה, שינוי עמדה, פירוט ומצב סיום. זה הופך כשלים לניתנים לאבחון: הרכב, זהות ותנועה כבר לא קורסים לאותה בעיה.
2. נתב דרמה, דיאלוג ותנועה קשה בנפרד
הערות ההפקה מסווגות את הצילומים כנרטיב רגיל, דיאלוג, תוכן למבוגרים, תנועה מורכבת, סביבה/מעבר או גימור/VFX. כל קטגוריה מקבלת דגמים משלה, מתאמים, פרמטרי דגימה, הפניות ומבחני קבלה משלה. הגדרה אוניברסלית אחת מראש נראית יעילה עד שניסיונות חוזרים ותיקונים מוחקים את החיסכון.
3. גרמו לדמות LoRA לענות רק "מי זה?"
דמויות מובילות זקוקות לחבילת זהות נקייה: חזית, פרופיל, שלושת רבעי צפיות, הבעות, שינויי תאורה, תצוגות של חצי גוף וגוף מלא ומצבי מלתחה חוזרים. הגיל, צורת הפנים, האיפור והפרופורציות חייבים להישאר עקביים בכל הנתונים; אחרת המתאם לומד ממוצע מעורפל.
זהות ותנועה מתמחה מאומנים בנפרד. מתאם הדמות קובע מי נמצא בפריים. מתאם תוכן או תנועה מתאר את הביצועים הנדרשים. המודולריות הזו מאפשרת לסטודיו להחליף דמות מבלי לאמן מחדש את כל ערימת התנועה, או לשפר את התנועה מבלי לשנות את פניו של המבצע.
הבחנה טכנית אחת חשובה: השחרור הרשמי של וואן מספק משקלים וקוד מסקנות. אימון LoRA מגיע בדרך כלל דרך כלים כגון DiffSynth-Studio, אשר המאגר הרשמי מפרט כשילוב קהילתי התומך ב-LoRA והדרכה מלאה. זה לא כפתור מובנה במוצר Wan מתארח.
4. נעל סטים חוזרים לפני רינדור
חדרי שינה, חדרי מגורים, בתי מלון ומסדרונות זקוקים לחבילות ייחוס משלהם. יש לקבוע את מיקומי הדלת והחלונות, כיוון הרהיטים, אור המפתח, טמפרטורת הצבע, חומרי הקיר ומצבי מצלמה שמישים. ככל שההופעה מתקשרת יותר עם מיטות, ספות או קירות, כך הסחף המרחבי הופך ברור יותר. תבנית סט היא גם התייחסות לכיוון אמנותי וגם מערכת קואורדינטות לשליטה בתנוחה ובעומק מאוחר יותר.
בנה את תמונת הסטילס הנכונה לפני שתבקש ממנה לזוז
צילומי נרטיב רגילים מתחילים כפריימים מפתח מאושרים. עדיין מבסס זהות, הבעה, מלתחה, קומפוזיציה, אור, תפאורה ותנוחת ההתחלה. צילומים מסובכים יותר פותרים גם את מספר התווים, מיקום יחסי, כיוון הגוף, חסימה, מגע סביבתי, זווית המצלמה וגבול המסגרת לפני תחילת יצירת הווידאו.
כל פריים מפתח צריך להיבדק באופן ידני. פרצופים, עיניים, ידיים, חיבורי גפיים, פרופורציות, קצוות לבוש, מגע רהיטים, השתקפויות, טקסט רקע ואובייקטים נוספים זולים יותר לתיקון פעם אחת בתמונת המקור מאשר על פני עשרות פריימים של וידאו.
שלוש שכבות הבקרה עבור יריות מיוחדות
שכבה 1: מסגרת המפתח נועלת את הזהות, התנוחה והמצלמה
דגם תמונה ומתאמים ייעודיים יוצרים את מסגרת הפתיחה המאושרת. רובד זה עונה למי נוכח, היכן הם נמצאים וכיצד ממוסגרת הסצנה. זה משאיר פחות מקום למודל הווידאו לעצב מחדש את היחסים בין הנושאים.
שכבה 2: Wan 2.2 I2V/TI2V מטפל בזמן
המסגרת המאושרת נכנסת למסלול Wan 2.2 I2V או TI2V עם המתאמים הממוקדים או כוונון עדין הנדרש על ידי אותה צילום. שכבה זו מטפלת בהמשכיות תנועה, שימור זהות, התמדה במרקם, תנועת מצלמה ותזמון. התיעוד הרשמי של Wan אומר ש-TI2V-5B תומך הן בטקסט לווידאו והן בתמונה לווידאו ב-720p ו-24fps, ויכול לרוץ על GPU לצרכן כמו RTX 4090.
שכבה 3: הפניות מורשות מתארות כיצד הפעולה נעה
תנועה קשה יכולה להוסיף סרטון עזר מורשה, רצפי תנוחות שלד או מידע עומק. תשומות אלו מגבילות מסלול, מהירות, שינוי משקל, כיוון, מרחק ומצב התחלה/סיום. מתאמי זהות שולטים במבצע; הפניות שולטות בתנועה; התבנית שנקבעה מגבילה מקום. הפרדת האחריות הזו מפחיתה את החלפת הדמויות, הצטלבות הגוף ומגע לא יציב.
צילומים רגילים, דיאלוג וגימור של 24 עד 30 פריימים לשנייה
עבור צילומים רגילים, יכולת העריכה מנצחת את המחזה
צור מספר מועמדים, ולאחר מכן בדוק את הזהות, תאימות ללוח התכנון, קו העין, המשכיות בארון הבגדים, קבע המשכיות, והאם ניתן לחתוך מסגרות גרועות בצורה נקייה. צילום מאופק ששורד מהפריים הראשון ועד האחרון הוא בעל ערך רב יותר ממהלך מצלמה שאפתני שמשתנה באמצע הדרך.
דיאלוג: Wan-S2V או מעבר ליפ-סינכרון נפרד
הפרויקט הרשמי Wan-S2V מתאר דגם שהופך תמונה אחת בתוספת אודיו לווידאו מסונכרן עם הבעות טבעיות, תנועת גוף והתנהגות מצלמה קולנועית. צילום דיאלוג שימושי עדיין כולל יותר מצורות פה. נשימה לפני דיבור, הפסקות, תנועת עיניים, יציבה והתגובה לאחר השורה הופכים את ההופעה לאמינה. כאשר S2V אינו המסלול הנכון, הצוות יכול ליצור תחילה את הצילום החזותי ולהחיל סינכרון שפתיים בפוסט.
24fps עד 30fps: מסגרות משוכפלות אינן אינטרפולציה
בהערות ההפקה נאמר שקטעי המקור של Wan נוצרו במהירות של 24 פריימים לשנייה והתאימו למאסטר של 30 פריימים לשנייה. המרת שכפול בסיסית מוסיפה שש מסגרות פלט בשנייה, או פריים אחד חוזר בכל חמש מסגרות פלט. אינטרפולציה של זרימה אופטית או בינה מלאכותית במקום זאת יוצרת מסגרות ביניים סינתטיות ויש לה דפוס חפץ שונה.
כל אחת מהשיטות מצריכה סקירה ברמת הירי. ידיים, שיער, דמויות חופפות ותנועה מהירה יכולים לייצר שגיאות מבניות חדשות בין מסגרות מקור שמישות אחרת. הגימור כלל גם העלאת קנה מידה, הבהוב, שחרור רעלים, התאמת צבעים, תיקון חשיפה, צביעה מקומית מחדש, הסרת מסגרת גרועה וייצוב אור.
סאונד ועריכה הופכים 117 קליפים לסרט אחד
השלמת יצירת וידאו פירושה רק שחומר הגלם קיים. דיאלוג TTS, אווירה, צליל פעולה, מוזיקה, מעברים, מיקס, הפחתת רעש ונורמליזציה של עוצמת הקול יוצרים המשכיות שמיעתית. כתוביות, גרפיקת הודעות, ממשקי מערכת, כותרות ו-VFX מאופקים נושאים את האריזה הנרטיבית.
העריכה הסופית חייבת לשמר את כיוון המסך, קווי עיניים, ארון בגדים, תאורה מוגדרת, פעולה בגזרה, סינכרון שפתיים ותזמון סאונד תוך הסרת כל פריים כושל. AI ייצר 117 חלקים נפרדים. העריכה גרמה להם להרגיש כמו קצר של שמונה דקות.
איזו חומרה דורשת זרימת עבודה זו?
24GB VRAM: מספיק כדי לאמת, לא בהכרח כדי לספק בקנה מידה
הפקודה הרשמית TI2V-5B של Wan יכולה לפעול עם לפחות 24GB של VRAM על ידי שימוש בהורדת מודלים, המרת dtype ומיקום CPU עבור T5. זה שימושי עבור מבחני אופי, פיתוח מהיר, מסגרות מפתח וקליפים מוגבלים. מסירה של 117 זריקות היא בעיית תפוקה: כל זריקה מאושרת עשויה לשבת מאחורי מספר ניסיונות שנדחו.
GPU כפול או צמתים מרובים: תורים מקבילים חשובים ביותר
NVIDIA מפרט 96GB של זיכרון GDDR7 ECC והספק של לוח מרבי של 600W עבור RTX PRO 6000 Blackwell Workstation Edition. לכן שני כרטיסים מייצגים 192GB מצטבר של VRAM ו-1,200W של הספק מרבי של לוח; ארבעה מייצגים 384GB ו-2,400W לפני מעבד, אחסון, זיכרון וקירור.
מאגר VRAM אינו אוטומטית מאגר זיכרון משותף אחד. שני כרטיסים של 96GB אינם מתנהגים מטבעם כמו כרטיס בודד בנפח 192GB. תוכנה חייבת להשתמש במקביליות נתונים, מקביליות מודלים, או עבודות עיבוד נפרדות כדי להועיל. עבור 117 צילומים, חלוקת עבודות עצמאיות על פני מספר צמתים היא לרוב גמישה יותר מאשר בניית תחנת עבודה אחת קיצונית.
רשימת תיוג איכות וזכויות ברמת הזריקה
- כל דמות מתוארת מוגדרת באופן מפורש ומוצגת כמבוגרת.
- פרצופים, קולות, הפניות לתנועה ונתוני הדרכה תיעדו הרשאה ומקור.
- אף אדם אמיתי לא מופיע בתוכן דיפזיוף אינטימי שלא בהסכמה.
- זהות, פנים ומבנה גוף תואמים את עיצוב הדמות המאושר.
- אין איברים מאוחדים, צמתים, אנטומיה לא מוסברת או תנועה לא קוהרנטית פיזית.
- ארון בגדים, גיאומטריה מוגדרת, תאורה וכיוון המסך ממשיכים על פני התמונות הסמוכות.
- הבהוב, כשלים בטקסטורה, טקסט שקרי ומסגרות אינטרפולציות הרסניות יוסרו.
- דיאלוג, ביצועי פנים וצליל פעולה מסונכרנים.
- קצב פריימים, רזולוציה, צבע ועוצמה עומדים במפרט הראשי.
- התפוקה פועלת בהתאם לחוק ולכללי הפלטפורמה הן במקומות הייצור והן במקומות ההפצה.
שאלות נפוצות
מדוע Wan 2.2 מתאים יותר לסרט קצר זה של AI למבוגרים?
זה לא אוטומטית טוב יותר עבור כל סרט. Huangguo נזקק למשקולות להורדה, מסקנות מקומיות, כלי אימון חיצוניים ותורים בניהול עצמי. עבור תוכן קונבנציונלי תואם מדיניות, זרימת העבודה הרב-מודאלית המתארחת של Seedance עשויה להיות פשוטה יותר.
למה לא להשתמש ב-Seedance?
Seedance מוצע לציבור כשירות דור מתארח, ו-Volcano Engine מתעד בדיקות בטיחות הכוללות סיכון פורנוגרפי. הממשק הציבורי שלו גם לא חושף את ערימת ההדרכה של מודל הבסיס למשתמשי הקצה. זה הופך אותו לבלתי תואם לצינור המסוים הזה של תוכן למבוגרים, מבלי להפחית את החוזקות שלו ליצירת סרטים רגילים.
האם ניתן להפיק סרט בינה מלאכותית של שמונה דקות במעבר אחד?
כעת קל יותר לשלוט ולתקן זרימת עבודה מבוססת צילום. Huangguo השתמש ב-117 תמונות שנבדקו באופן עצמאי, ולאחר מכן הסתמך על עריכה וסאונד כדי לבנות המשכיות.
האם Stable Diffusion או Flux עדיין חשובים?
כֵּן. מודלים של תמונות נשארים שימושיים עבור תפניות של דמויות, הגדרות הפניות ומסגרות מפתח. דגמי וידאו ופוסט-פרודקשן מטפלים בתנועה, דיאלוג והמשכיות זמנית.
האם יש למזג אופי ותוכן LoRA?
בדרך כלל לא. הפרדת זהות מיכולת תנועה או תוכן הופכת את ההחלפה, הדרכה מחדש וניפוי באגים לקלים יותר. העיצוב הסופי עדיין תלוי בגודל מערך הנתונים ובשיטת האימון.
האם מחשב אישי יכול לעשות זאת?
זה יכול להתחיל עם TI2V-5B על 24GB GPU. עם זאת, "יכול להציג קליפ" ו"יכול לספק 117 צילומים מאושרים על לוח הזמנים" הם ספים שונים. אחסון, ניסיונות חוזרים, ניהול תורים וביקורת אנושית הופכים חשובים לא פחות.
החסם האמיתי הוא פס ייצור פרטי
ניתן לסכם את שיטת Huangguo באופן הבא: מבנה את הסיפור כצילומי הפעלה; נעילת זהות עם מתאמי תווים; לשמור על שטח עם תבניות מוגדרות; לאשר מסגרות מפתח; הנפשת קליפים קצרים עם Wan 2.2 וגרסאות ממוקדות; להנחות תנועה קשה עם הפניות מורשות; נתב דיאלוג דרך S2V או סינכרון שפתיים; לאחר מכן סיים צליל, צבע, אינטרפולציה ועריכה על ציר זמן של 30 פריימים לשנייה.
Seedance מייצג יצירת וידאו מתארח רב עוצמה. Wan 2.2 מספק משקלים, קוד מסקנות ועוד מקום לשינוי המערכת. עבור הפרויקט החוקי והמורשה הזה - עם הדגש שלו על פרטיות וייצור אצווה חוזר - ההבדל הזה היה מכריע. ההשוואה נועדה לעזור לקוראים לשפוט איזה מסלול תואם את התוכן, התקציב, המיומנות הטכנית וחובות הציות שלהם, לא למסור "המודל הטוב ביותר" אוניברסלי אחד.