Die kurze Antwort: Der interessante Teil des Huangguo Ist nicht, dass AI beteiligt war. Es ist, dass die Filmemacher nicht ein Modell gebeten haben, einen achtminütigen Film aus einer Aufforderung zu erstellen. Nach den für diese Fallstudie gelieferten Produktionsnotizen teilten sie den Film in 117 Kurzaufnahmen und kontrollierte Identität, Keyframes, Bewegung, Dialog und Finishing als separate Probleme. Wan 2.2 war die Grundlage, weil das Projekt lokale Gewichte, eine modifizierbare Pipeline und eine nachhaltige Chargenproduktion benötigte - nicht weil Seedance keine visuelle Qualität hat.
Über die Beweise: die 8-Minuten-Laufzeit, 117-Schuss-Zählung, 3,2-Sekunden-Medianschusslänge und der projektspezifische Prozess stammen aus dem für diesen Artikel gelieferten Produktionsmaterial von Huangguo. Externe Links überprüfen die öffentlichen Wan-, Seedance-, Wan-S2V- und NVIDIA-Fähigkeiten; diese Unternehmen haben das private Produktionsprotokoll des Films nicht überprüft.
Dieser artikel behandelt rechtmäßige, einwilligungsbasierte produktion mit eindeutig nur erwachsenen charakteren. Es unterstützt keine alterszweideutigen inhalte, minderjährige oder nicht einvernehmliche intime deepfakes.
Warum Wan 2.2 statt Seedance?
Seedance ist nicht das schwache Modell in diesem Vergleich. Die offizielle Seite von ByteDance hebt Bild-, Audio- und Videoreferenzen sowie die Kontrolle über Leistung, Beleuchtung und Kamerabewegung hervor. Für ein herkömmliches Projekt, das polierte gehostete Fähigkeiten wünscht, ohne die lokale Infrastruktur aufrechtzuerhalten, kann dies ein großer Vorteil sein.
Huangguo hatte eine andere Einschränkung. Mehr als hundert Schüsse benötigt wiederholte Probenahme. Charakteridentität, Bewegung und Dialog mussten unabhängig angepasst werden. Ein fehlgeschlagener Schuss musste von jedem Stadium wiederherstellbar sein. Das Studio musste auch seine Trainingsressourcen und die Generationswarteschlange besitzen. Wan 2.2 veröffentlicht Modellgewichte und Inferenzcode mit T2V-, I2V-, TI2V- und S2V-Pfaden, die in ein privates Rendersystem integriert werden können.
| Produktionsanforderung | Local Wan 2.2 Workflow | Öffentliches Saatgut |
|---|---|---|
| Zugang zu Modellen | Herunterladbare Gewichte und Inferenzcode | Fertige Funktionen durch gehostete Produkte oder APIs |
| Lokale Inferenz | Offizielle lokale Anweisungen | Öffentliche Modellseite bietet keine herunterladbaren Basisgewichte |
| LoRA und gezieltes Training | Kann sich mit Community LoRA / Full-Training-Tools verbinden | Der Basismodell-Trainingsstack wird nicht über die öffentliche Schnittstelle ausgesetzt |
| Chargenproduktion | Selbstverwaltete Warteschlangen, Caches und Multi-Node-Planung | Vorbehaltlich API-Quoten, Preis- und Serviceregeln |
| Erwachsener Inhalt | Lokale Ausführung; der Produzent bleibt für Gesetz, Zustimmung und Sicherheit verantwortlich | Volcano Engine gibt an, dass sein Sicherheitssystem pornografische Risiken erkennt und blockiert |
| Am besten geeignet | Trainierbare, reversible private Produktionslinie | Bequeme multimodale Generierung für richtlinienkonformes Arbeiten |
Dies ist eine Workflow-Entscheidung, kein universelles Bildqualitätsranking. Seedance bietet einen starken Managed Service. Huangguo benötigte Besitz von Gewichten, Daten und Planungslogik. Die eigene sicherheitserstellungsseite von vulcano engine sagt auch, dass seine plattform eindeutig nicht konforme eingaben und ausgaben steuert, mit besonderer aufmerksamkeit auf pornografische risiken, was sie als zentralen generator für diesen fall ausschließt.
Warum acht Minuten in 117 Schüsse aufgeteilt?
Längere Generationen vervielfachen die Anzahl der Dinge, die driften können: Gesichter, Hände, Kleidung, Hintergrundgeometrie, Kontakt zwischen Charakteren, Beleuchtung und Kamerabewegung. Ein kleiner Fehler in einer komplexen Interaktion kann sich über Sekunden zusammensetzen. Kurzaufnahmen sind nicht automatisch schneller; sie machen jedes Rendering überprüfbar.
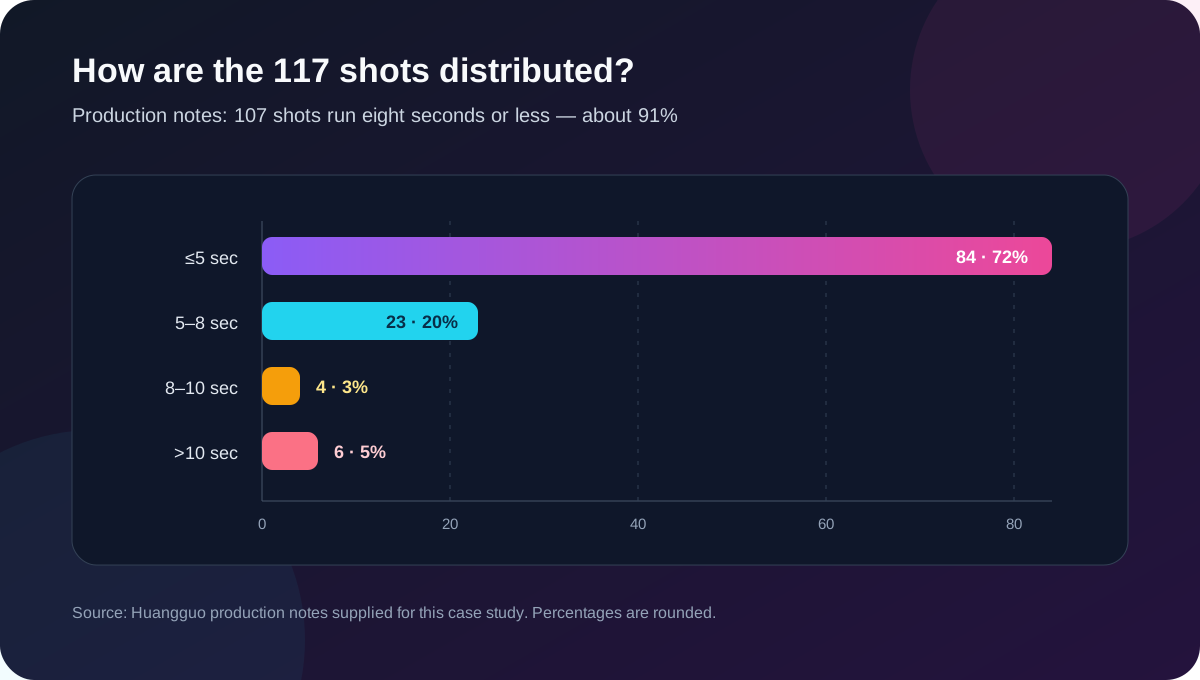
Eine Drei-zu-Acht-Sekunden-Aufnahme kann einem Job zugewiesen werden: einer Augenlinie, einer Wendung, einem Satz, einer Bewegungsphase, einer Winkeländerung oder einer Detaileinlage. Komplexe Szenen können aus breiten Aufnahmen, Nahaufnahmen, Einsätzen und Reaktionen wieder aufgebaut werden. Das Gefühl der kontinuierlichen Leistung entsteht in der Bearbeitung, anstatt von einer Generation verlangt zu werden.
Die Produktionslinie beginnt mit ausführbaren Schüssen
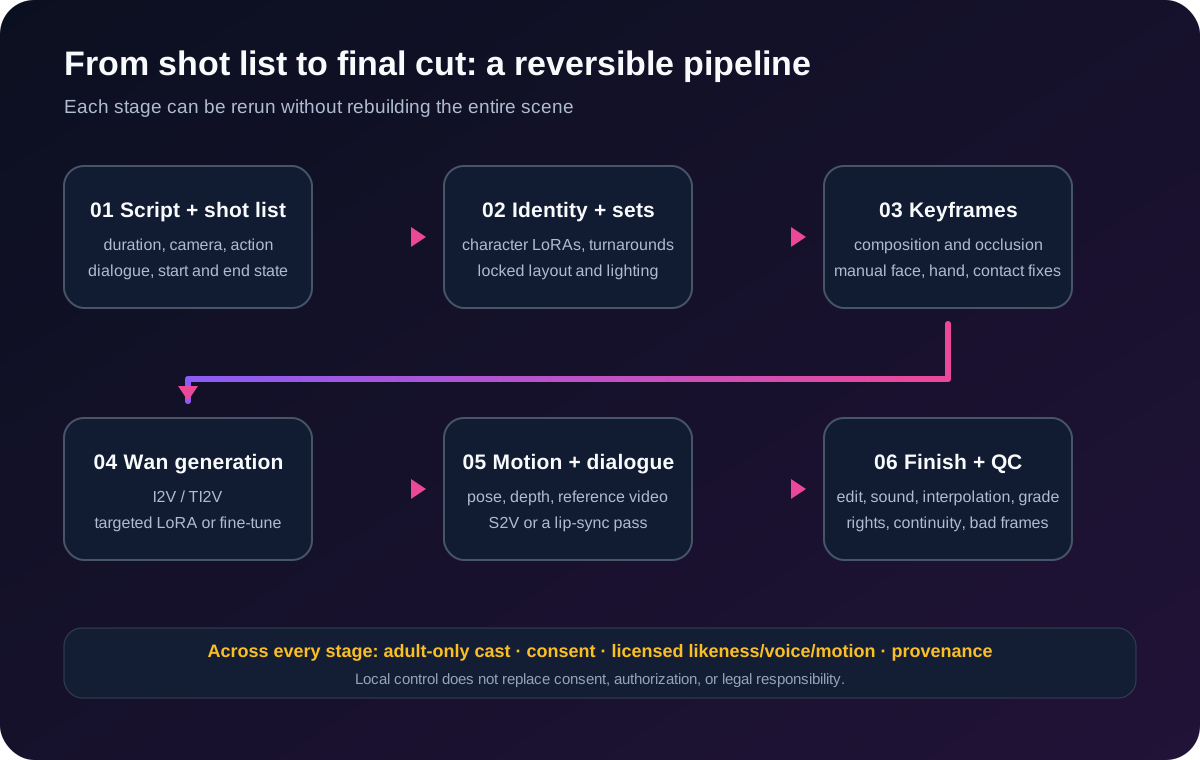
1. Verwandeln Sie das Skript in eine Produktionsdatenbank
Ein LLM kann helfen, Handlung, Beziehungen, Dialog und Szenenordnung zu organisieren. Sein Prosaentwurf ist keine brauchbare Render-Aufgabe. Jede Aufnahme benötigt eine ID, Set, Cast, Framing, Kameraposition, Aktion, Emotion, Dialog, Dauer, Öffnungszustand, Endzustand, Modellroute und jede erforderliche Bewegung oder Audioreferenz.
"Zwei Charaktere vervollständigen eine komplexe Interaktion in einem Raum" ist zu vage. Die Szene muss in Eingang, Annäherung, Reaktion, Positionsänderung, Detail und Endzustand unterteilt werden. Das macht Fehler diagnostizierbar: Zusammensetzung, Identität und Bewegung kollabieren nicht mehr in dasselbe Problem.
2. Route Drama, Dialog und schwierige Bewegung getrennt
Die Produktionsnotizen klassifizieren Aufnahmen als reguläre Erzählung, Dialog, Inhalte für Erwachsene, komplexe Bewegungen, Umgebung / Übergang oder Finishing / VFX. Jede Kategorie erhält ihre eigenen Modelle, Adapter, Sampling-Parameter, Referenzen und Akzeptanztests. Ein universelles Preset sieht effizient aus, bis Wiederholungen und Reparaturen das Sparen löschen.
3. Lassen Sie den Charakter LoRA nur antworten "Wer ist das?"
Hauptfiguren benötigen ein sauberes Identitätspaket: Front, Profil, Dreiviertelansichten, Ausdrücke, Lichtänderungen, Halb- und Ganzkörperansichten und wiederkehrende Garderobenzustände. Alter, Gesichtsform, Make-up und Proportionen müssen in den Daten konsistent bleiben; Andernfalls lernt der Adapter einen vagen Durchschnitt.
Identität und spezialisierte Bewegung werden separat trainiert. Der Charakteradapter legt fest, wer sich im Frame befindet. Ein Content- oder Motion-Adapter beschreibt die erforderliche Performance. Diese Modularität ermöglicht es dem Studio, einen Charakter zu ersetzen, ohne den gesamten Bewegungsstapel neu zu trainieren, oder die Bewegung zu verbessern, ohne das Gesicht des Darstellers zu verändern.
Eine technische Unterscheidung ist wichtig: Wans offizielle Veröffentlichung liefert Gewichte und Inferenzcode. LoRA-Schulungen werden im Allgemeinen durch Tools wie DiffSynth-Studio durchgeführt, die im offiziellen Repository als Community-Integration aufgeführt sind, die LoRA und vollständige Schulungen unterstützt. Es ist kein Button, der in ein gehostetes Wan-Produkt eingebaut ist.
4. Wiederholte Sets vor dem Rendern sperren
Schlafzimmer, Wohnzimmer, Hotels und Flure benötigen eigene Referenzpakete. Tür- und Fensterpositionen, Möbelorientierung, Schlüssellicht, Farbtemperatur, Wandmaterial und verwendbare Kamerapositionen sollten fixiert werden. Je mehr eine Performance mit Betten, Sofas oder Wänden interagiert, desto offensichtlicher wird die räumliche Drift. Eine festgelegte Schablone ist sowohl eine Art-Direction-Referenz als auch ein Koordinatensystem zur späteren Pose- und Tiefenkontrolle.
Erstellen Sie das richtige Standbild, bevor Sie es bitten, sich zu bewegen
Regelmäßige narrative Aufnahmen beginnen als genehmigte Keyframes. Der Still etabliert Identität, Ausdruck, Garderobe, Komposition, Licht, Set und die Ausgangspose. Kompliziertere Aufnahmen lösen auch die Anzahl der Charaktere, die relative Position, die Körperorientierung, die Okklusion, den Umgebungskontakt, den Kamerawinkel und die Rahmengrenze, bevor die Videoerzeugung beginnt.
Jeder Keyframe sollte manuell überprüft werden. Gesichter, augen, hände, gliedmaßenverbindungen, proportionen, bekleidungskanten, möbelkontakt, reflexionen, hintergrundtext und zusätzliche objekte sind billiger, einmal im quellbild zu beheben als über dutzende von videorahmen.
Die drei Kontrollschichten für spezialisierte Aufnahmen
Schicht 1: Der Keyframe sperrt Identität, Pose und Kamera
Ein speziell erstelltes Bildmodell und Adapter erstellen den genehmigten Öffnungsrahmen. Diese Ebene beantwortet, wer anwesend ist, wo sie sich befinden und wie die Szene eingerahmt wird. Es lässt weniger Raum für das Videomodell, um die Beziehung zwischen den Themen neu zu gestalten.
Schicht 2: Wan 2.2 I2V/TI2V verarbeitet die Zeit
Der genehmigte Rahmen betritt eine Wan 2.2 I2V- oder TI2V-Route mit den gezielten Adaptern oder der für diese Aufnahme erforderlichen Feinabstimmung. Diese Schicht behandelt Bewegungskontinuität, Identitätserhaltung, Texturpersistenz, Kamerabewegung und Timing. Wans offizielle Dokumentation besagt, dass TI2V-5B sowohl Text-zu-Video als auch Bild-zu-Video mit 720p und 24fps unterstützt und auf einer Verbraucher-GPU wie einer RTX 4090 ausgeführt werden kann.
Schicht 3: Lizenzierte Referenzen beschreiben, wie sich die Aktion bewegt
Schwierige Bewegungen können autorisierte Referenzvideos, Skelettposesequenzen oder Tiefeninformationen hinzufügen. Diese Eingaben beschränken Flugbahn, Geschwindigkeit, Gewichtsverschiebung, Orientierung, Entfernung und Start-/Endzustand. Identitätsadapter steuern den Darsteller; Referenzen steuern die Bewegung; die festgelegte Vorlage beschränkt den Raum. Die Trennung dieser Verantwortlichkeiten reduziert Charakterwechsel, Körperschnittpunkte und instabilen Kontakt.
Regelmäßige Aufnahmen, Dialoge und das 24-zu-30fps-Finish
Für regelmäßige Aufnahmen schlägt die Bearbeitbarkeit das Spektakel
Generieren Sie mehrere Kandidaten, dann überprüfen Sie Identität, Storyboard-Compliance, Eyeline, Garderobenkontinuität, setzen Sie Kontinuität und ob schlechte Frames sauber geschnitten werden können. Eine zurückhaltende Aufnahme, die vom ersten Bild bis zum letzten überlebt, ist wertvoller als eine ehrgeizige Kamerabewegung, die zur Hälfte mutiert.
Dialog: Wan-S2V oder ein separater Lip-Sync-Pass
Das offizielle Wan-S2V-Projekt beschreibt ein Modell, das ein Bild plus Audio in synchronisiertes Video mit natürlichen Ausdrücken, Körperbewegung und filmischem Kameraverhalten verwandelt. Ein nützlicher Dialogschuss beinhaltet immer noch mehr als Mundformen. Atem vor der Rede, Pausen, Augenbewegung, Haltung und die Reaktion nach der Linie machen die Leistung glaubwürdig. Wenn S2V nicht die richtige Route ist, kann das Team zuerst die visuelle Aufnahme generieren und die Lippensynchronisation in der Post anwenden.
24fps bis 30fps: Duplizierte Frames sind keine Interpolation
In den Produktionsnotizen heißt es, dass die Wan-Quellclips mit 24 fps generiert wurden und einem 30fps-Master entsprachen. Eine grundlegende Duplikationskonvertierung fügt sechs Ausgaberahmen pro Sekunde oder einen wiederholten Rahmen in jedem fünf Ausgaberahmen hinzu. Die Optical-Flow- oder AI-Interpolation erzeugt stattdessen synthetische Zwischenbilder und hat ein anderes Artefaktmuster.
Jede Methode benötigt Shot-Level-Überprüfung. Hände, Haare, überlappende Figuren und schnelle Bewegung können neue strukturelle Fehler zwischen ansonsten verwendbaren Quellrahmen erzeugen. Die Fertigstellung umfasste auch Upscaling, Deflickering, Denoising, Farbanpassung, Belichtungskorrektur, lokale Neulackierung, Bad-Frame-Entfernung und Lichtstabilisierung.
Sound und Bearbeitung verwandeln 117 Clips in einen Film
Das Ausfüllen der Videogenerierung bedeutet nur, dass das Rohmaterial existiert. TTS-Dialog, Ambiente, Action-Sound, Musik, Übergänge, Mischen, Geräuschreduzierung und Lautheitsnormalisierung schaffen auditive Kontinuität. Untertitel, Messaging-Grafiken, Systemschnittstellen, Titel und zurückhaltende VFX tragen die narrative Verpackung.
Die endgültige Bearbeitung muss die Bildschirmrichtung, die Augenlinien, den Kleiderschrank, die eingestellte Beleuchtung, die Aktion am Schnitt, die Lippensynchronisation und das Tontiming beibehalten, während jeder fehlgeschlagene Rahmen entfernt wird. AI produzierte 117 separate Stücke. Durch das Bearbeiten fühlten sie sich wie ein achtminütiger Kurzfilm an.
Welche Hardware benötigt dieser Workflow?
24GB VRAM: genug, um zu validieren, nicht unbedingt, um im Maßstab zu liefern
Wans offizieller TI2V-5B-Befehl kann mit mindestens 24 GB VRAM ausgeführt werden, indem Modellabladung, dtype-Konvertierung und CPU-Platzierung für T5 verwendet werden. Das ist nützlich für Charaktertests, prompte Entwicklung, Keyframes und begrenzte Clips. Eine 117-Schuss-Lieferung ist ein Durchsatzproblem: Jeder genehmigte Schuss kann hinter mehreren abgelehnten Versuchen stehen.
Dual GPU oder mehrere Knoten: Parallele Warteschlangen sind am wichtigsten
NVIDIA listet 96 GB GDDR7 ECC-Speicher und 600 W maximale Platinenleistung für die RTX PRO 6000 Blackwell Workstation Edition auf. Zwei Karten repräsentieren daher 192 GB Aggregat-VRAM und 1.200 W maximale Boardleistung; vier repräsentieren 384 GB und 2.400 W vor CPU, Speicher, Speicher und Kühlung.
Aggregate VRAM ist nicht automatisch ein gemeinsamer Speicherpool. Zwei 96GB-Karten verhalten sich nicht wie eine einzige 192GB-Karte. Software muss Datenparallelismus, Modellparallelismus oder separate Renderjobs verwenden, um davon zu profitieren. Für 117 Aufnahmen ist die Verteilung unabhängiger Jobs auf mehrere Knoten oft flexibler als der Aufbau einer extremen Workstation.
Checkliste für Qualität und Rechte auf Schussebene
- Jeder abgebildete Charakter wird explizit als Erwachsener definiert und dargestellt.
- Gesichter, Stimmen, Bewegungsreferenzen und Trainingsdaten haben Autorisierung und Herkunft dokumentiert.
- Keine reale Person erscheint in nicht einvernehmlichen intimen Deepfake-Inhalten.
- Identität, Gesicht und Körperstruktur entsprechen dem genehmigten Charakterdesign.
- Es gibt keine verschmolzenen Gliedmaßen, Kreuzungen, ungeklärte Anatomie oder körperlich inkohärente Bewegung.
- Garderobe, eingestellte Geometrie, Beleuchtung und Bildschirmrichtung setzen sich über benachbarte Aufnahmen fort.
- Flicker, Texturfehler, falscher Text und destruktive interpolierte Frames werden entfernt.
- Dialog, Gesichtsleistung und Action-Sound werden synchronisiert.
- Frame Rate, Auflösung, Farbe und Lautstärke entsprechen der Masterspezifikation.
- Der Output folgt den Gesetzen und Plattformregeln sowohl an Produktions- als auch an Vertriebsstandorten.
Häufig gestellte Fragen
Warum passt Wan 2.2 besser zu diesem KI-Kurzfilm für Erwachsene?
Es ist nicht automatisch besser für jeden Film. Huangguo benötigte herunterladbare Gewichte, lokale Rückschlüsse, externe Trainingswerkzeuge und selbstverwaltete Warteschlangen. Für richtlinienkonforme konventionelle Inhalte kann der gehostete multimodale Workflow von Seedance einfacher sein.
Warum nicht Seedance verwenden?
Seedance wird öffentlich als gehosteter generation-service angeboten, und volcano engine dokumentiert sicherheitsüberprüfungen, die pornografische risiken beinhalten. Die öffentliche Schnittstelle stellt auch den Basismodell-Schulungsstack nicht den Endbenutzern zur Verfügung. Das macht es inkompatibel mit dieser speziellen erwachsenen-inhalts-pipeline, ohne seine stärken für das gewöhnliche filmemachen zu verringern.
Kann ein achtminütiger KI-Film in einem Durchgang generiert werden?
Ein schussbasierter Workflow ist derzeit einfacher zu steuern und zu reparieren. Huangguo verwendete 117 unabhängig überprüfte Aufnahmen und verließ sich dann auf die Bearbeitung und den Ton, um Kontinuität aufzubauen.
Sind stabile Diffusion oder Flux noch wichtig?
Ja. Bildmodelle bleiben nützlich für Charakter-Turnarounds, eingestellte Referenzen und Keyframes. Videomodelle und Postproduktion behandeln Bewegung, Dialog und zeitliche Kontinuität.
Sollten Charakter und Inhalt LoRAs zusammengeführt werden?
Normalerweise nicht. Die Trennung von Identität und Bewegungs- oder Inhaltsfähigkeit erleichtert das Ersetzen, Umschulen und Debuggen. Das endgültige Design hängt immer noch von der Größe des Datensatzes und der Trainingsmethode ab.
Kann ein Personal Computer das tun?
Es kann mit TI2V-5B auf einer 24 GB GPU beginnen. "Kann einen Clip rendern" und "kann 117 genehmigte Aufnahmen im Zeitplan liefern" sind jedoch unterschiedliche Schwellenwerte. Storage, Retries, Warteschlangenmanagement und menschliche Überprüfung werden ebenso wichtig.
Die eigentliche Barriere ist eine private Produktionslinie
Die Huangguo-Methode kann wie folgt zusammengefasst werden: Strukturieren Sie die Geschichte als ausführbare Aufnahmen; sperren Sie die Identität mit Charakteradaptern; bewahren Sie den Raum mit festgelegten Vorlagen; genehmigen Sie Keyframes; animieren Sie kurze Clips mit Wan 2.2 und gezielten Varianten; führen Sie schwierige Bewegungen mit lizenzierten Referenzen; Routendialog durch S2V oder Lippensynchronisation; dann beenden Sie Sound, Farbe, Interpolation und Bearbeitung auf einer 30fps Zeitleiste.
Seedance stellt eine leistungsstarke gehostete Videogeneration dar. Wan 2.2 bietet Gewichte, Inferenzcode und mehr Raum, um das System zu modifizieren. Für dieses rechtmäßige, autorisierte Projekt - mit seinem Schwerpunkt auf Privatsphäre und wiederholter Serienproduktion - war dieser Unterschied entscheidend. Der Vergleich soll den Lesern helfen zu beurteilen, welche Route ihren eigenen Inhalten, ihrem Budget, ihren technischen Fähigkeiten und ihren Compliance-Verpflichtungen entspricht, und nicht ein universelles "bestes Modell" zu übergeben.
Offizielle Quellen
- Wan 2.2 offizielles Repository: Gewichte, Inferenz, Hardwarebeispiele und Integrationen von Community-Trainings
- Wan 2.2 TI2V-5B offizielles Modell
- Wan-S2V offizielle Projektseite
- ByteDance Seedance 2.0 Offizielle Übersicht
- Seedance 2.0 Sicherheits-Erstellungs-Framework von Volcano Engine
- NVIDIA RTX PRO 6000 Blackwell offizielle Spezifikationen