Ieri ho finito di testare una configurazione per accelerare MiniMax H3. Oggi ne è arrivata un'altra.
Naturalmente.
ComfyUI nel 2026 funziona così: il benchmark non ha neppure il tempo di raffreddarsi che qualcuno pubblica un nuovo nodo e fa sembrare tutto già superato. La configurazione di ieri era EasyCache più SageAttention. Oggi si sono aggiunti Spectrum e un altro plugin di accelerazione che circola nella community cinese di ComfyUI. Più o meno nello stesso periodo, Wan-Animate-2 è finalmente diventato open source, dandomi un'altra scusa per confrontarlo con SCAIL-2.
Così, invece di uno, i test sono diventati tre:
- EasyCache + SageAttention contro Spectrum su MiniMax H3;
- l'output H3 standard contro un fine-tuning NSFW realizzato dalla community;
- Wan-Animate-2 contro SCAIL-2 per l'animazione dei personaggi.
In breve: EasyCache ha stravinto la prova cronometrica, il filmato NSFW pubblicato dimostra meno di quanto prometta il prompt e i due esempi di animazione dei personaggi non sono minimamente controllati a sufficienza per decretare un vincitore. La versione lunga è più interessante.
Nota dell'editor: Questo testo è un adattamento in inglese naturale di appunti pratici pubblicati originariamente da 璧礙K鎼濧I su WeChat, non una traduzione riga per riga. I risultati dei test e le opinioni in prima persona sono quelli dell'autore originale; il contesto tecnico e le avvertenze sono stati verificati consultando i repository ufficiali dei progetti.
Prima di tutto, il test di velocità: 692 secondi contro 1.590 secondi
Entrambe le esecuzioni di MiniMax H3 hanno generato un filmato verticale di 15 secondi a 544 × 960. Il workflow EasyCache + SageAttention ha terminato in 692,69 secondi, cioè circa 11 minuti e 33 secondi. Spectrum ha impiegato 1.590,15 secondi, cioè circa 26 minuti e 30 secondi.
In questa prova, EasyCache + SageAttention è stato quindi circa 2,3 volte più veloce. Ha ridotto l'attesa di poco più del 56%.
| Configurazione MiniMax H3 | Output | Tempo misurato | Risultato relativo |
|---|---|---|---|
| EasyCache + SageAttention | 15 s, 544 × 960 | 692,69 s | 1,0× |
| Spectrum | 15 s, 544 × 960 | 1.590,15 s | 2,3 volte più lungo |
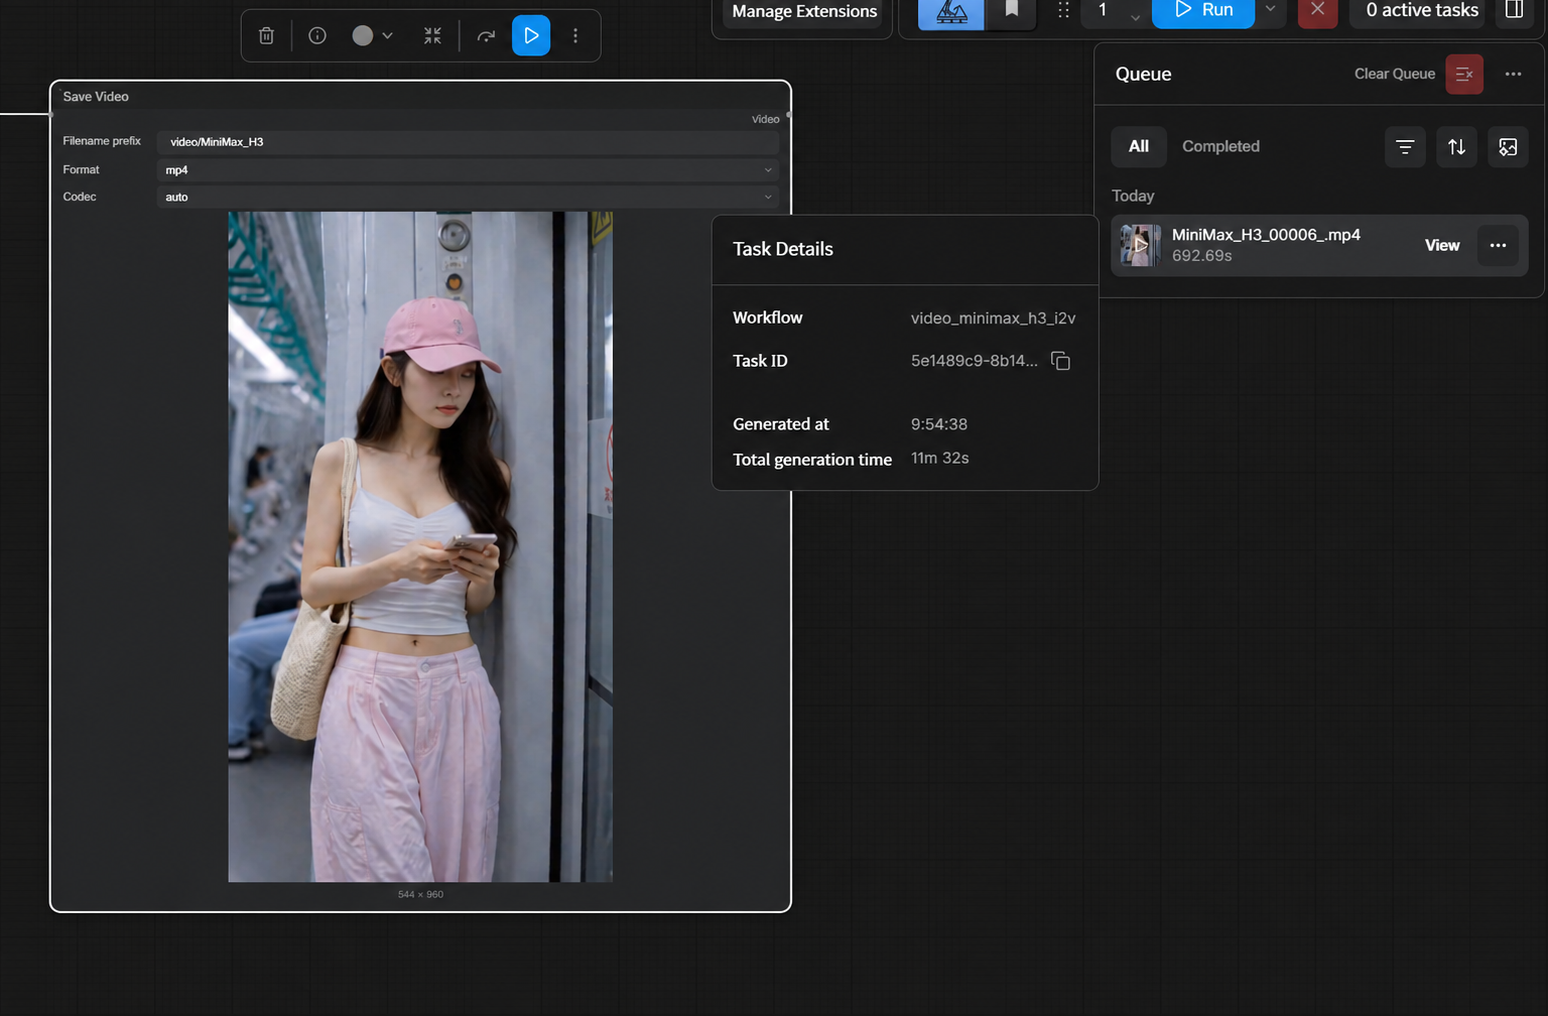
L'esecuzione con EasyCache + SageAttention registrata in ComfyUI. Immagine di origine: 璧礙K鎼濧I.
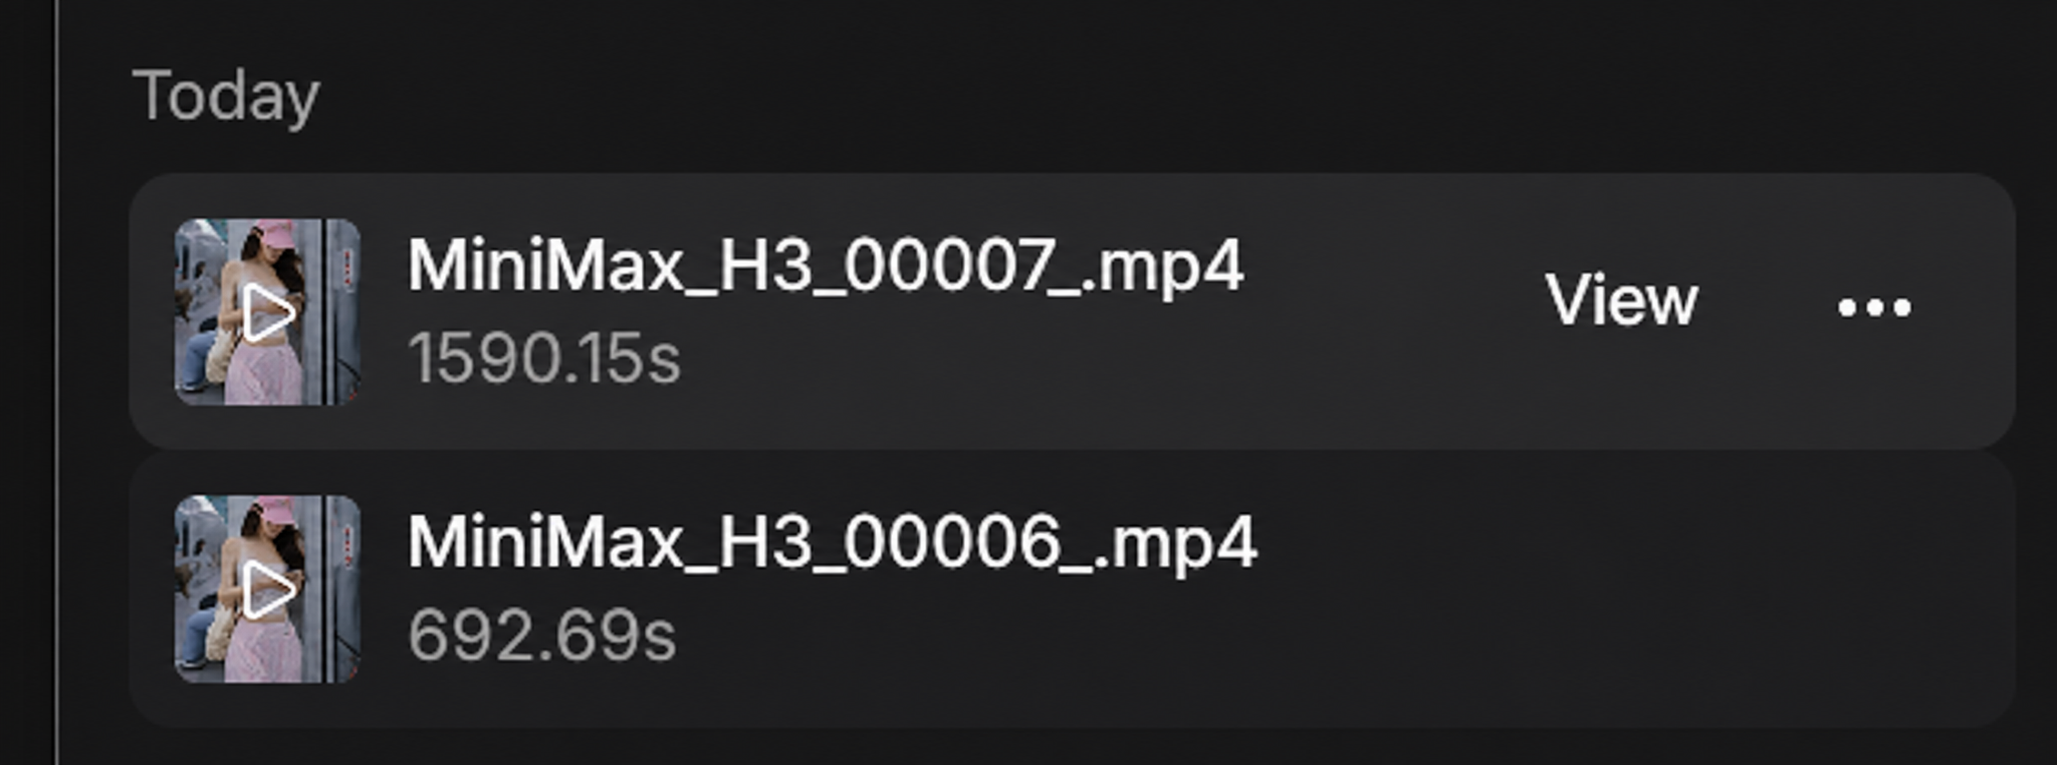
I tempi registrati delle due attività. Questa è l'acquisizione utile: ci evita di fingere che «sembrava più veloce» sia un benchmark. Immagine di origine: 璧礙K鎼濧I.
L'output di 15 secondi di MiniMax H3 allegato al test di accelerazione. Video di origine: 璧礙K鎼濧I.
Prima che qualcuno trasformi quel dato di 2,3× in una legge universale: non fatelo. L'articolo non fornisce una scheda di riproducibilità completa con modello di GPU, versioni del software, seed, parametri di campionamento e impostazioni di ogni nodo. È il risultato reale di un singolo workflow, non una classifica delle velocità sottoposta a revisione paritaria.
Ciò detto, una differenza tanto ampia non è irrilevante. Se la mia unica domanda fosse «quale configurazione mi consente di ottenere prima un'altra bozza su questa macchina?», EasyCache + SageAttention sarebbe la prima scelta più ovvia.
Perché EasyCache è stato più veloce in questo caso
I due acceleratori non usano lo stesso trucco.
EasyCache adotta l'approccio più aggressivo. In parole semplici, cerca di riutilizzare il lavoro svolto nei precedenti passaggi di denoising, anziché ripetere ogni volta l'intero calcolo. Se la generazione rimane stabile, può far risparmiare molta potenza di calcolo. Il rischio è altrettanto facile da capire: se la stima memorizzata nella cache inizia a deviare, l'errore può accumularsi.
Spectrum è più prudente. La sua implementazione per ComfyUI usa la previsione delle caratteristiche, ossia la previsione di Chebyshev e la regressione ridge, per anticipare le caratteristiche intermedie del transformer, lasciando poi al modello il compito di continuare a perfezionare il risultato. Somiglia meno a fotocopiare il passaggio precedente e più ad abbozzare quello successivo in base alla traiettoria recente, prima che il modello lo ripulisca.
Questo rende Spectrum interessante sul piano tecnico. In questo test specifico, però, non lo ha reso veloce.
| Che cosa cambia | EasyCache + SageAttention | Spectrum |
|---|---|---|
| Idea di base | Riutilizzare i calcoli precedenti e ridurre il costo dell'attention | Prevedere le caratteristiche intermedie dalla cronologia recente |
| Da dove deriva il guadagno | Saltare una quantità maggiore di lavoro ripetuto | Evitare parte dei calcoli del transformer |
| Probabile compromesso | Maggiore possibilità che la deviazione si accumuli | Accelerazione più prudente |
| Risultato in questo test | 692,69 s | 1.590,15 s |
Manca un vero confronto visivo A/B: stesso seed, stessa sorgente, stesso prompt, stesse impostazioni di campionamento ed entrambi gli output disponibili alla massima qualità. Senza questi elementi posso dire quale esecuzione è terminata per prima, ma non posso affermare onestamente quale metodo abbia conservato più dettagli.
È una distinzione importante. È anche il criterio con cui cerchiamo di separare le dichiarazioni di un fornitore dai risultati osservabili nella metodologia di recensione di NSFWAITool. Un cronometro può dimostrare la velocità, ma da solo non può dimostrare la qualità delle immagini.
Il «modello NSFW MiniMax H3» richiede un asterisco
La versione NSFW discussa qui non era una versione ufficiale di MiniMax. Il repository ufficiale di MiniMax H3 descrive un modello multimodale di uso generale. La build destinata ai contenuti per adulti proveniva da un autore indipendente della community, che secondo quanto riferito aveva testato cinque versioni.
Il link è scomparso rapidamente e, al momento della verifica, restituiva già un errore 404. È seccante, ma è anche normale in questo angolo dell'AI open source: un modello può essere pubblicato, duplicato su un mirror, rinominato o eliminato prima che la maggior parte delle persone finisca di scaricarlo. Se un workflow di produzione dipende dalla presenza eterna online di un unico repository della community non verificato, quel workflow non esiste ancora davvero.
Il test originale usava per il modello di riferimento un lungo prompt di moda con più telecamere. Specificava un reel verticale di 15 secondi, più obiettivi e angolazioni, stile, musica, illuminazione e identità coerenti tra gli stacchi. Il risultato di H3 standard è riportato qui sotto.
Output di moda di riferimento generato da MiniMax H3. Il simbolo «V» visibile fa parte del filmato originale ed è stato conservato. Video di origine: 璧礙K鎼濧I.
Per il test destinato agli adulti, il prompt ha mantenuto la stessa struttura con più telecamere, ma ha trasformato la progressione dell'abbigliamento in una sequenza esplicita in cui il soggetto si spoglia. È un modo sensato di testare un fine-tuning: si conserva la progettazione delle inquadrature e si modifica il comportamento che si vuole effettivamente misurare.
Ecco il risultato pubblico incluso nell'articolo originale:
Teaser pubblicato per il fine-tuning NSFW della community. Le didascalie originali in cinese sono state sostituite da sottotitoli in inglese; il simbolo «V» rimane parte del video originale. Video di origine: 璧礙K鎼濧I.
Ed ecco dove devo guastare un po' il marketing: il filmato pubblico non mostra l'intera sequenza in cui il soggetto si spoglia descritta nel prompt. Il soggetto rimane vestito e il video termina con una battuta provocante che equivale a: «Se vuoi davvero vederlo, provalo tu». Divertente? Sì. Dimostra che sia stato eseguito per intero il comportamento senza censura? No.
Lo considererei quindi una prova dell'esistenza di un fine-tuning H3 NSFW della community, capace di produrre un teaser coerente a tema adulto. Non userei però il filmato pubblico come prova dell'esecuzione di tutte le istruzioni esplicite. Sono due affermazioni diverse, e fonderle è il modo in cui le demo di AI diventano assurde.
Se state confrontando soluzioni ospitate e locali per i video per adulti, la più ampia directory dei generatori di video pornografici con AI è un punto di partenza migliore che puntare tutto su un repository eliminato.
Wan-Animate-2 è diventato open source, quindi sì, ho testato anche quello
Wan-Animate-2 ha pubblicato il codice di inferenza e i pesi del modello nell'agosto 2026. Il progetto anima direttamente un personaggio di riferimento a partire da un video sorgente, cercando di preservarne identità, movimento, espressione e comportamento della telecamera. È un sistema end-to-end, quindi non richiede un estrattore di pose separato nel mezzo della pipeline.
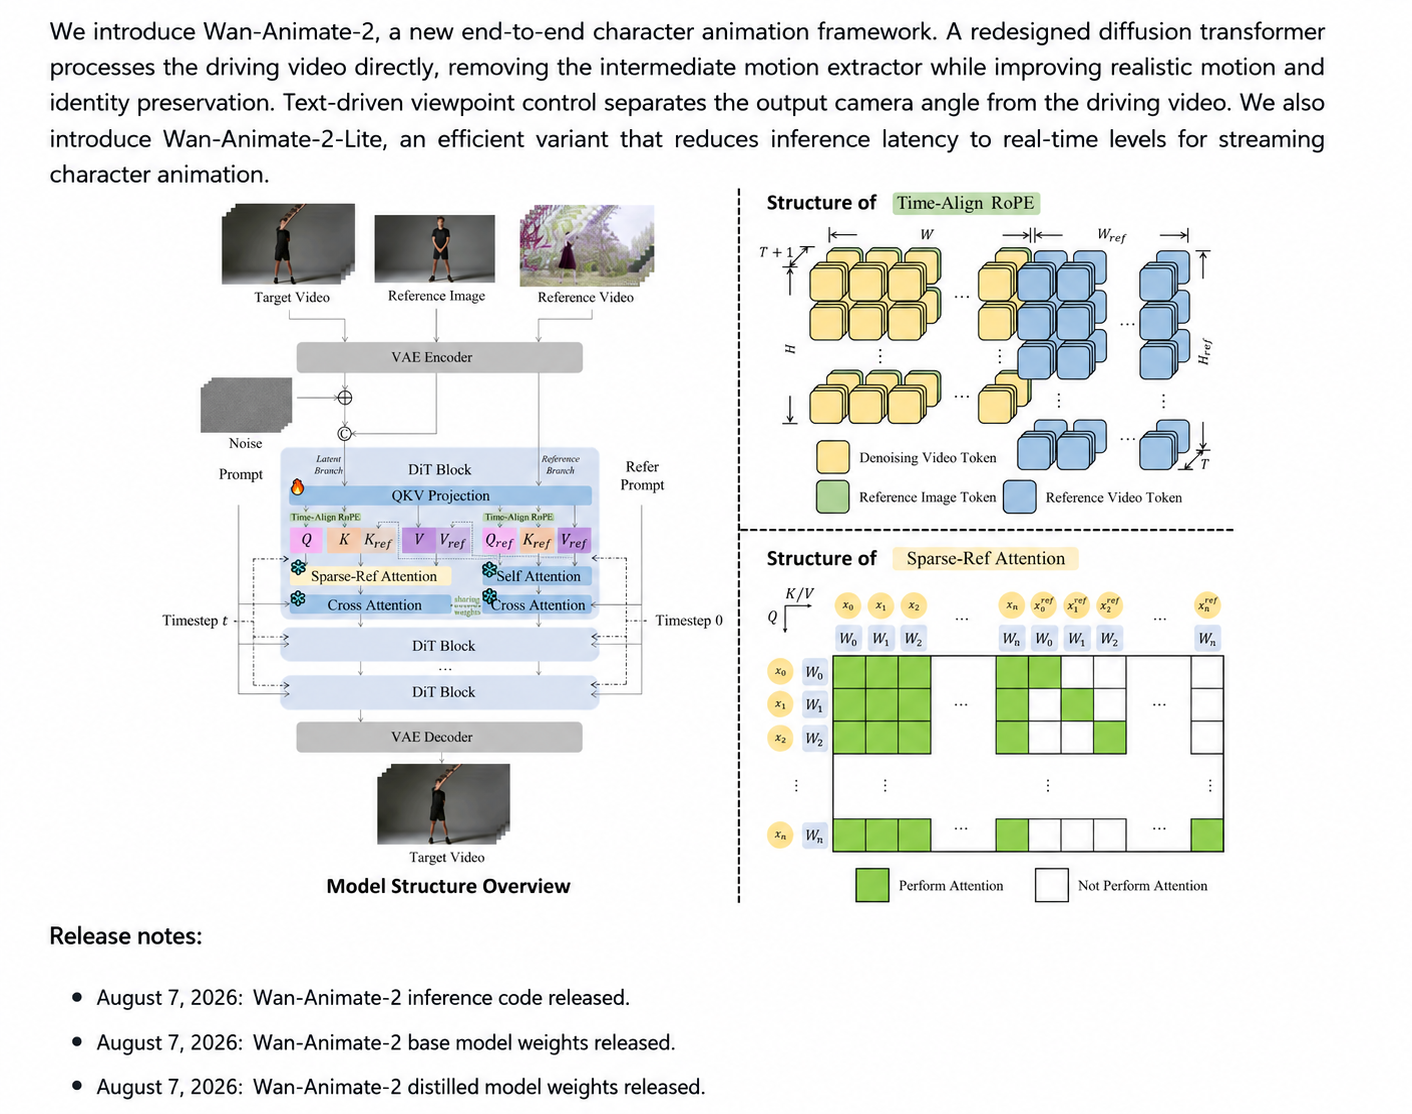
Panoramica della pipeline di Wan-Animate-2 inclusa nell'articolo originale. Immagine di origine: 璧礙K鎼濧I; dettagli tecnici: progetto Wan-Animate-2.
Una breve digressione, perché a quanto pare va ancora detto: Wan 3.0 non è open source. È una delusione. Questo non rende intelligenti o fondate le offese anonime rivolte agli sviluppatori. State usando modelli che altre persone hanno impiegato mesi a costruire e poi vi comportate come se foste stati traditi personalmente perché non vi hanno consegnato il successivo secondo i tempi che preferivate. Se sapete costruire Wan 4.0 da soli, fatelo pure. Sarò il primo a chiedervi di pubblicarne i pesi.
Il fatto che Wan-Animate-2 sia diventato open source non risolve magicamente la discussione su Wan 3.0, ma resta comunque una pubblicazione importante. L'ecosistema Wan rimane uno dei pochi ambienti in cui si può davvero ispezionare e modificare il modello, collegandolo a una pipeline ComfyUI privata. È ancora più importante per i progetti destinati agli adulti, perché i prodotti ospitati potrebbero non consentire affatto quel materiale. Il nostro approfondimento sul workflow di Wan 2.2 per cortometraggi per adulti spiega perché il controllo locale diventa un requisito produttivo quando un progetto va oltre pochi filmati.
La configurazione di Wan-Animate-2 nasconde un passaggio facile da dimenticare
Prima di eseguire l'animazione, l'immagine di riferimento deve essere descritta con un LLM. Il progetto ufficiale consiglia una descrizione oggettiva dell'aspetto del personaggio e dello sfondo, escludendo azioni, giudizi soggettivi e supposizioni sulle emozioni.
In un italiano naturale, l'istruzione è sostanzialmente questa:
Descrivi soltanto ciò che è visibile nell'immagine di riferimento. Includi l'aspetto del soggetto, l'abbigliamento, i capelli, gli accessori e lo sfondo. Non descrivere azioni. Non fare supposizioni sulla personalità, sull'umore o sulle intenzioni.
Sembra pignolo finché non si capisce perché è utile. Il video sorgente fornisce già l'azione. Se la descrizione testuale ne inventa un'altra, si finisce per dare al modello due registi che gridano istruzioni diverse.
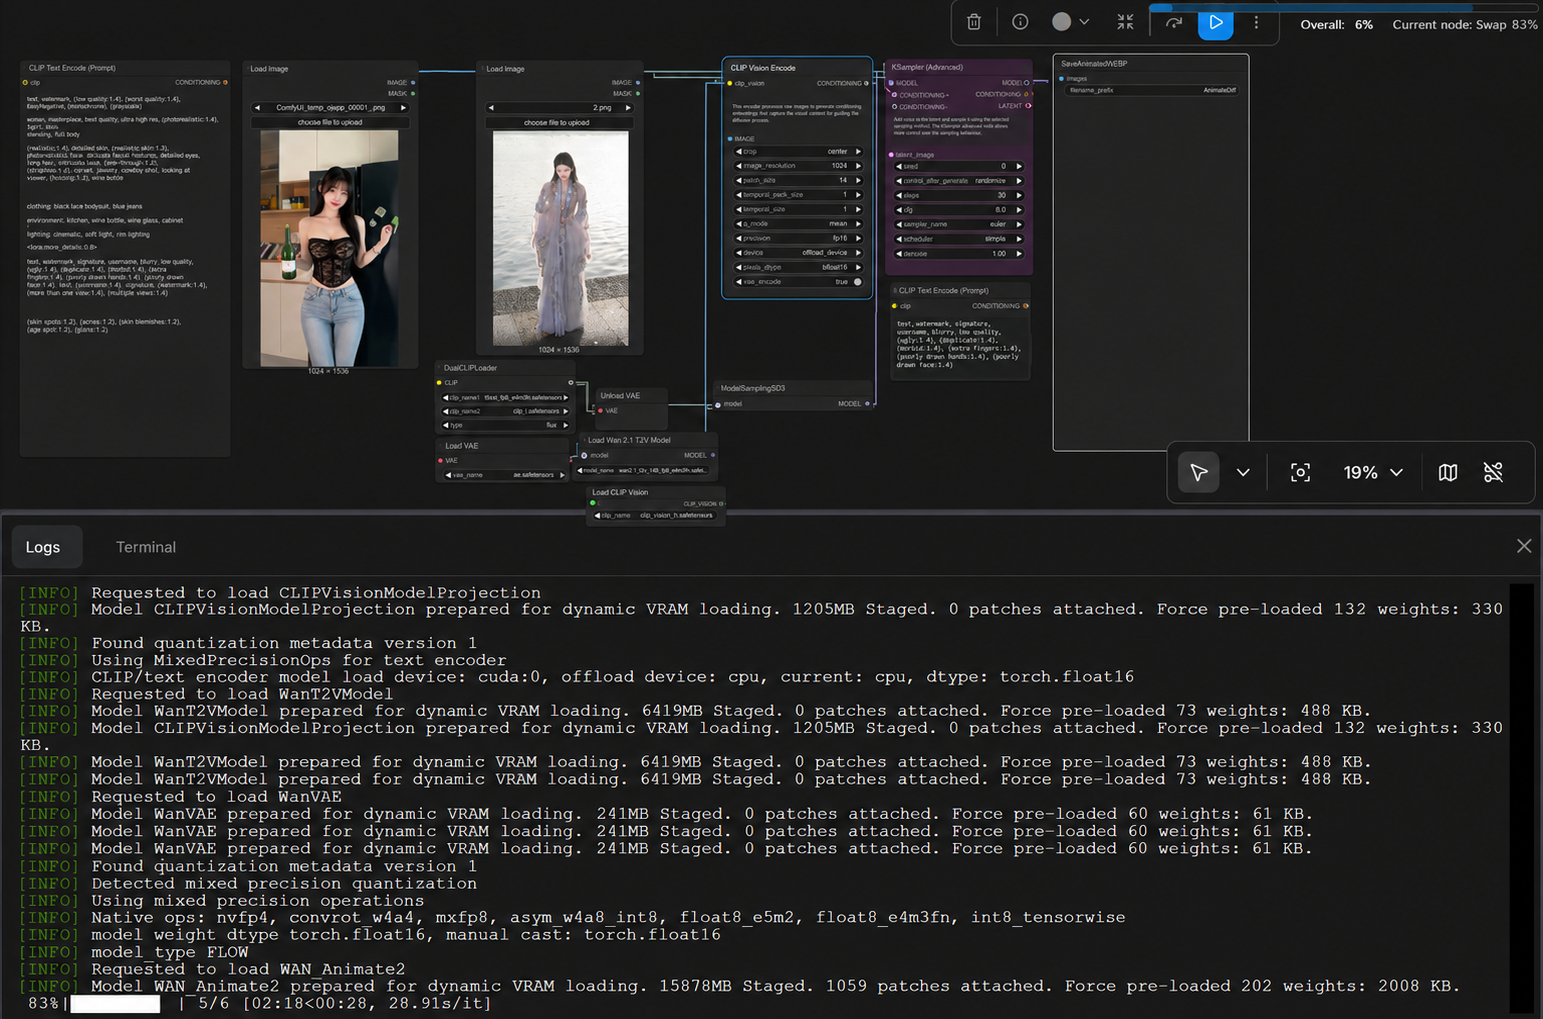
Wan-Animate-2 in ComfyUI. Immagine di origine: 璧礙K鎼濧I.
L'altra impostazione che viene spesso sbagliata è la lunghezza in fotogrammi. A 24 fps, il calcolo è semplice:
durata in secondi × 24 = numero di fotogrammi desiderato
Il workflow mostrato nella fonte usa blocchi da 81 fotogrammi, quindi i filmati più lunghi richiedono più passaggi.
| Durata desiderata | Fotogrammi a 24 fps | Blocchi da 81 fotogrammi necessari |
|---|---|---|
| 3 secondi | 72 | 1 |
| 5 secondi | 120 | 2 |
| 8 secondi | 192 | 3 |
| 10 secondi | 240 | 3 |
| 15 secondi | 360 | 5 |
| 30 secondi | 720 | 9 |
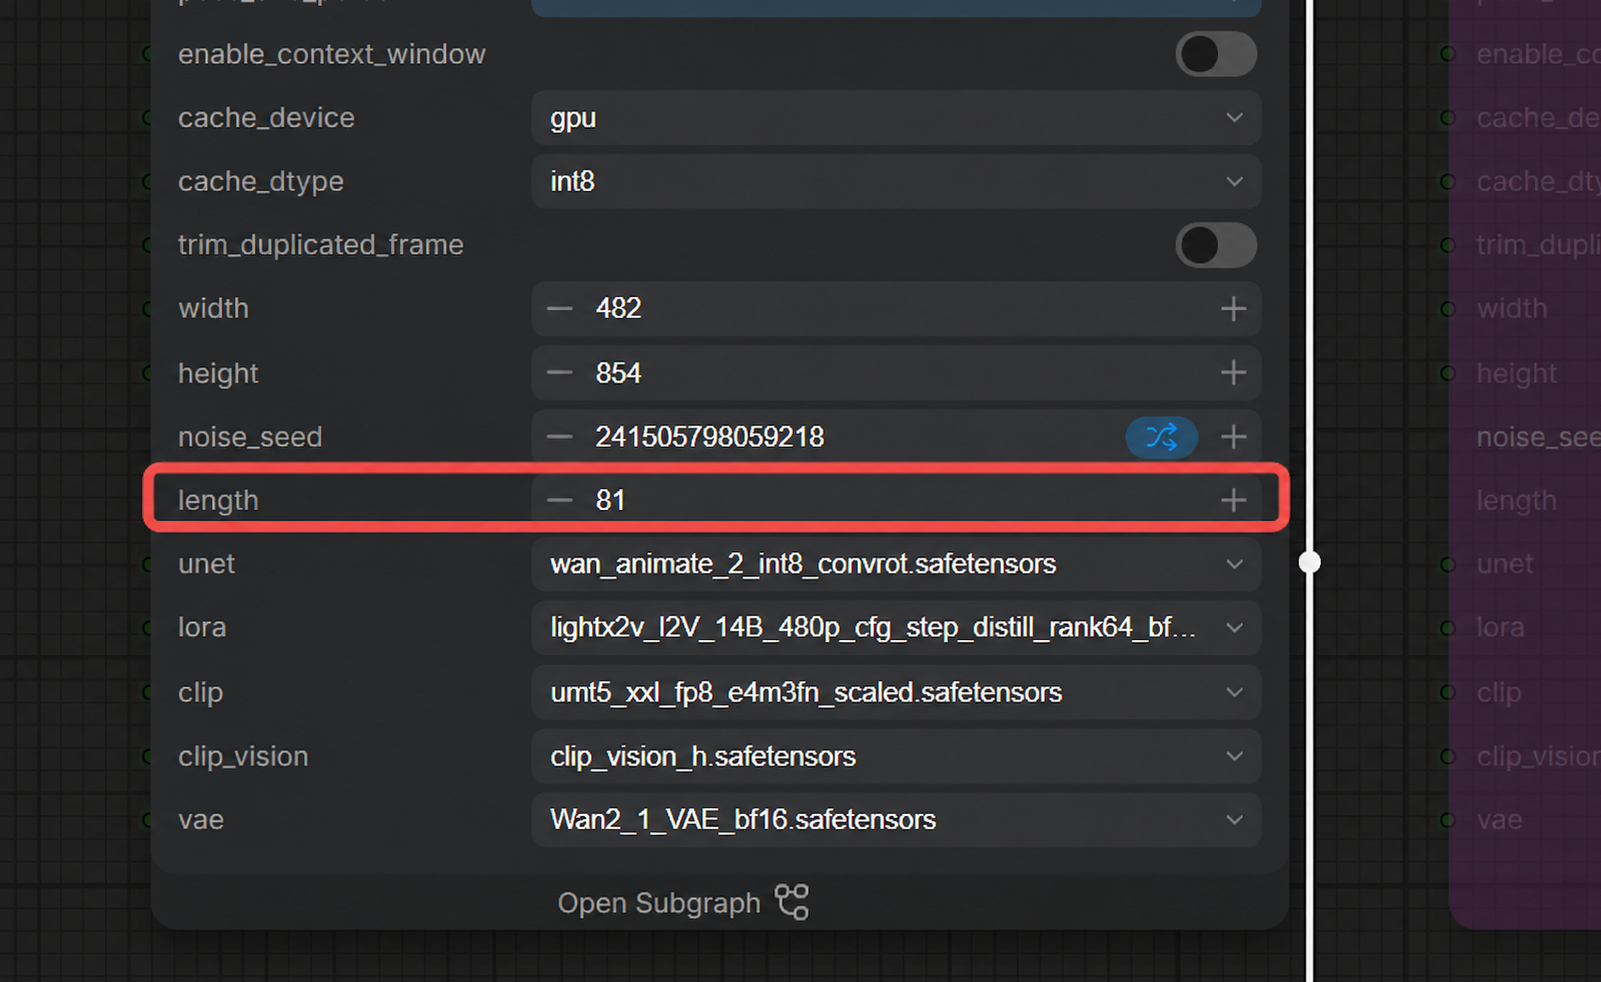
L'impostazione della lunghezza a 81 fotogrammi usata nel workflow. Immagine di origine: 璧礙K鎼濧I.
La configurazione predefinita a 720p del repository ufficiale è ottimizzata per otto GPU A800, mentre è stata testata una configurazione a 480p su due A800. Non è proprio un requisito da «faccio clic su Queue Prompt sul portatile». Le ottimizzazioni della community continueranno ad abbassare il requisito minimo di memoria, ma chi ne parla come se l'animazione locale dei personaggi fosse gratuita evidentemente non ha mai osservato una barra di avanzamento trascinarsi lungo un workflow reale.
Wan-Animate-2 contro SCAIL-2: i filmati non dimostrano chi vinca
Il progetto SCAIL-2 adotta un approccio end-to-end simile. Evita una rappresentazione intermedia della posa e aggiunge la semantica delle maschere e il condizionamento su più riferimenti. La versione ufficiale supporta workflow a 512p e 704p; il progetto consiglia la variante guidata dalla posa a 704p.
Ecco l'esempio di Wan-Animate-2 conservato dall'articolo originale:
Esempio di Wan-Animate-2. Il file sorgente alterna rapidamente la vista del movimento/riferimento e il personaggio generato; è riprodotto qui senza modifiche. Video di origine: 璧礙K鎼濧I.
Ed ecco l'esempio di SCAIL-2:
Esempio di animazione dei personaggi con SCAIL-2. Video di origine: 璧礙K鎼濧I.
Non proclamerò un vincitore sulla base di questi due filmati, perché sarebbe una falsa precisione. Usano personaggi, sorgenti del movimento, inquadrature e durate differenti. Il video di Wan-Animate-2 dura soltanto circa 2,7 secondi e alterna le viste così rapidamente che è difficile valutare i difetti temporali. Il filmato di SCAIL-2 dura quasi nove secondi ed è molto più facile da esaminare, ma «più facile da esaminare» non significa «modello migliore».
Un confronto autentico richiede la stessa immagine di riferimento, lo stesso video sorgente del movimento, la stessa risoluzione, lo stesso numero di fotogrammi, lo stesso hardware, la stessa politica dei seed e la stessa post-produzione. A quel punto valuterei la conservazione dell'identità, la stabilità delle mani, il recupero dalle occlusioni, le espressioni facciali, il movimento dei tessuti, le contaminazioni dello sfondo e il tempo totale di rendering. Qualunque confronto meno rigoroso si limita ai filmati dimostrativi.
Che cosa userei davvero dopo questi test
Per velocizzare le iterazioni di MiniMax H3, partirei da EasyCache + SageAttention. In questa prova il divario è troppo ampio per ignorarlo. Genererei comunque alcuni esempi comparabili prima di accettare il compromesso sulla qualità, perché una maggiore velocità che danneggia silenziosamente volti o movimenti non è vera velocità: produce soltanto scarti più in fretta.
Considererei Spectrum l'alternativa interessante e più prudente, non il vincitore di questa prova cronometrica. Merita un test controllato della qualità, soprattutto se EasyCache inizia ad accumulare errori visibili in un'inquadratura più lunga o complessa.
Per il fine-tuning H3 NSFW della community, aspetterei un repository stabile, una scheda del modello, una cronologia delle versioni ed esempi riproducibili. Un link scomparso e un teaser ammiccante bastano a incuriosirmi, ma non a costruirci intorno un workflow di produzione.
Per Wan-Animate-2 contro SCAIL-2, eseguirei prove mie con input identici. Entrambi i progetti sono abbastanza aperti da meritare test seri. Gli esempi dell'articolo originale semplicemente non rispondono alla domanda.
Forse suona meno entusiasmante di «Il modello A distrugge il modello B», ma è molto più utile. Nei benchmark dell'AI c'è già abbastanza falsa certezza. Non serve fabbricare un altro vincitore partendo da due video non correlati.
Domande frequenti
MiniMax H3 è ufficialmente un modello NSFW?
No. MiniMax H3 è un modello multimodale di uso generale. La build NSFW discussa qui era un fine-tuning indipendente della community, non una versione ufficiale di MiniMax.
EasyCache è sempre più veloce di Spectrum su MiniMax H3?
Non è dimostrato. In questo test specifico di 15 secondi a 544 × 960, EasyCache + SageAttention è stato circa 2,3 volte più veloce. Hardware, seed, versioni dei nodi e impostazioni della qualità differenti potrebbero cambiare il risultato.
La demo NSFW pubblica ha eseguito per intero il prompt esplicito?
Il filmato pubblicato non lo dimostra. Il soggetto rimane vestito e il video termina come un teaser, quindi non può confermare l'intera sequenza in cui si spoglia descritta nel prompt.
Wan-Animate-2 è migliore di SCAIL-2?
I due filmati originali non costituiscono un confronto controllato. Usano input e durate differenti, quindi dimostrano che entrambi i workflow funzionano, non quale dei due sia migliore.
Perché il workflow di Wan-Animate-2 usa 81 fotogrammi?
È la lunghezza dei blocchi usata nel workflow ComfyUI mostrato. A 24 fps, gli obiettivi più lunghi vengono suddivisi in più blocchi da 81 fotogrammi e poi assemblati.
Di quante GPU ha bisogno Wan-Animate-2?
Il progetto ufficiale documenta una configurazione predefinita a 720p su otto GPU A800 e una configurazione a 480p testata su due A800. I nodi della community e l'offloading possono ridurre il requisito, di solito a scapito della velocità.
Questi modelli possono essere usati per contenuti per adulti?
La disponibilità locale non elimina gli obblighi legali o relativi al consenso. Usate soltanto personaggi chiaramente adulti e immagini di riferimento, voci e filmati sorgente del movimento correttamente concessi in licenza. Non create deepfake intimi di persone reali senza consenso.